


최신연구
[한욱신 교수] Hi-Q: 다단계 질의응답을 위한 계층적 근거 기반 질의 개선
- 등록일2026.10.15
- 조회수16
-

교수한욱신
[연구의 필요성]
다단계 질의응답(multi-hop QA)은 하나의 질문에 답하기 위해 여러 문서에 흩어진 사실을 순서대로 연결해야 하는 문제이다. 이때 질문이 표현된 단위(granularity)와 코퍼스에서 증거를 실제로 검색할 수 있는 단위가 서로 다른 경우가 많다. 질문을 그대로 검색기에 넣으면 개별 단어만 맞는 문단이 올라오고 추론 체인은 놓치며, 그래프 기반 RAG는 질문이 들어오기 전에 코퍼스 쪽 구조를 미리 고정하고, 반복 검색 방식은 후속 질의를 만들어내지만 그 질의가 코퍼스에서 해결 가능한 단위인지는 검사하지 않는다. 즉 기존 방법들은 "언제 질의를 더 잘게 나눠야 하는가"를 검색된 증거로부터 결정하지 않는다.
이 문제는 수백만 문단 규모의 전체 코퍼스 환경에서 특히 두드러진다. MuSiQue에서 원래 질문으로는 필요한 근거 문단을 모두 찾는 경우가 7.9%에 그치며, 그래프 기반 방법은 HotpotQA 전체 코퍼스(약 520만 문단)에 대해 LLM 기반 그래프를 구축하는 데만 수천 달러의 API 비용이 든다. 따라서 사전 구축된 그래프나 별도의 미세조정 없이, 질의 단위를 코퍼스가 뒷받침하는 수준으로 스스로 조정하는 검색 방법이 필요하다.
[포스텍이 가진 고유의 기술]
본 연구는 이 병목을 "검색 가능한 단위의 발견(retrievable granularity discovery)" 문제로 정식화하고, 증거에 조건화된 계층적 질의 정제 프레임워크 Hi-Q를 제안하였다. Hi-Q는 질의 트리의 각 노드에서 해결 연산자(resolution operator)가 검색된 증거로 현재 질의 단위에 답할 수 있는지 검사하여, 답할 수 있으면 노드를 종료(RESOLVED)하고 그렇지 않으면 노드를 확장(UNRESOLVED)한다. 그 결과 질의 트리의 모양은 고정된 분해 템플릿이나 사전 구축 그래프가 아니라 코퍼스의 지원 신호에 의해 결정된다.
(1) 실패 인지형 증거 유도 단위 제어: Hi-Q는 리더(reader)가 검색된 문단으로부터 답을 시도하는 과정 자체를 제어 신호로 사용하므로 별도의 학습이 필요 없다. 본 연구는 "멈출 것인가, 분해할 것인가"의 결정이 미해결 지원(unresolved support) 확률에 대한 비용 민감 임계값 규칙으로 유도됨을 보였다. 미해결 노드에서 멈추면 답 자체를 잃는 반면 불필요한 분해는 몇 번의 추가 호출만 치르므로 임계값은 1/2보다 훨씬 낮고, 가장 단순한 학습 없는 테스트도 이미 올바른 쪽에 놓인다. 또한 질의만 보고 전략을 고르는 정책은 같은 질의가 증거에 따라 반대 행동을 요구하기 때문에 제거할 수 없는 양의 후회(regret)를 가진다는 점을 증명하였다.
(2)의존성 인지 계층적 질의 분해: 미해결 노드는 이진 분해 연산자에 의해 두 개의 하위 질의로 나뉘며, 선행 하위 질의를 먼저 해결하는 의존성 제약과 분해가 원 질문의 의미를
보존하는지 확인하는 왕복(round-trip) 검증 제약을 만족해야 한다. 선행 가지에서 얻은 중간 개체(예: "III의 연주자" → Stanton Moore)를 후속 하위 질의에 반영하여 검색 간섭을 줄이며, 검증기는 트리거된 분해의 14.8~18.8%를 수리한다.
[연구의 의미]
세 개의 다단계 QA 벤치마크(HotpotQA, MuSiQue, 2WikiMultiHopQA)의 전체 코퍼스 검색 환경에서 Hi-Q는 평균 52.3 EM / 64.0 F1을 기록하여 반복 검색 방법 IRCoT를 15.2 EM / 18.2 F1, 그래프 기반 방법 PropRAG를 MuSiQue 전체 코퍼스에서 11.6 EM / 12.0 F1 차이로 앞섰으며, 코드 생성형 에이전트 방식보다도 큰 폭으로 우수하였다. 이는 코퍼스 전체에 대한 그래프 구축이나 과제별 미세조정 없이 달성한 결과이며, 선행 연구들이 사용한 제한된 코퍼스 설정에서도 57.9 EM / 69.3 F1로 최고 성능을 보였다.
제안한 신호가 실제로 작동함을 분석으로 확인하였다. 정제 과정은 원 질의가 놓친 근거 문단을 회수하여 동일한 검색 예산에서 전체 근거 확보율을 7.9%에서 42.7%로, 전체 후보 풀에서는 57.7%까지 끌어올렸고, 처음에 실패했던 질문의 38.7%를 최종적으로 맞혔다. 트리거 100건의 수작업 분석에서 90%는 실제로 미해결 상태였으며, 답할 수 있는 질의에서의 오보류율은 11%, 답할 수 없도록 조작한 질의에서의 오수락률은 2%에 그쳤다.
효율 면에서도 의미가 있다. 재귀 깊이를 제한한 비용 대응 구성은 IRCoT와 같은 LLM 호출 수(2.93 대 2.92)에서 입력 토큰을 9.4배 적게 쓰고 25% 빠르며 질문당 비용이 8.5배 낮으면서도 평균 10.4 EM / 11.6 F1 높은 정확도를 보였다. 추론 단계가 깊어질수록 격차는 커져 4단계 질문에서 Hi-Q는 39.2 F1로 IRCoT(26.9)와 PropRAG(35.4)를 앞섰다.
[연구결과의 진행 상태 및 향후 계획]
본 연구는 인공지능 분야 최고 권위 학회인 NeurIPS 2026에 채택되었으며, 논문은 arXiv에, 코드와 프로젝트 페이지는 공개 저장소에 공개되어 있다. 향후에는 학습 없는 해결 테스트를 보정된 분류기나 함의(entailment) 모델로 대체하는 연구, 상호 의존적인 하위 질의를 다루도록 상태 표현을 확장하는 연구, 그리고 장문·다국어·표-텍스트·멀티모달 질의응답으로의 확장을 계획하고 있다.
[성과와 관련된 실적]
J. Kim, S. Park, and W.-S. Han, "Hi-Q: Hierarchical Evidence-guided Query Refinement for Multi-Hop Question Answering," In Proc., the 40th Annual Conference on Neural Information Processing Systems, NeurIPS, December 2026. (arXiv:2608.30468)
[성과와 관련된 프로젝트 홈페이지]
https://hi-q-project.github.io/
[성과와 관련된 이미지]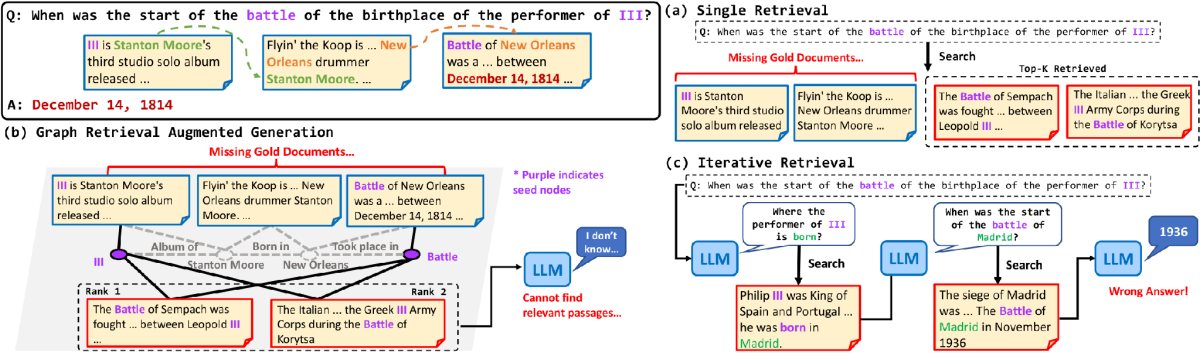
그림 1. 다단계 질문에서 기존 검색 방법들이 실패하는 사례: (a) 단일 검색, (b) 그래프 기반 RAG, (c) 반복 검색.
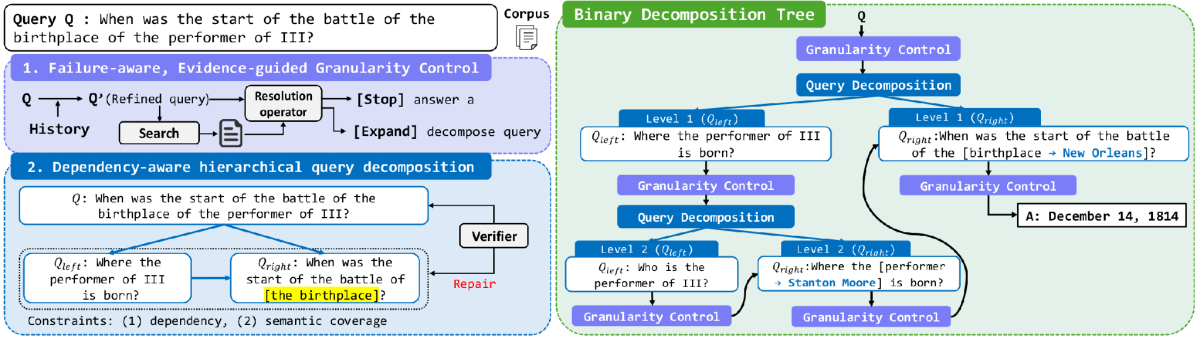
그림 2. Hi-Q 개요: 실패 인지형 증거 유도 단위 제어와 의존성 인지 계층적 질의 분해, 그리고 그로부터 만들어지는 이진 분해 트리.
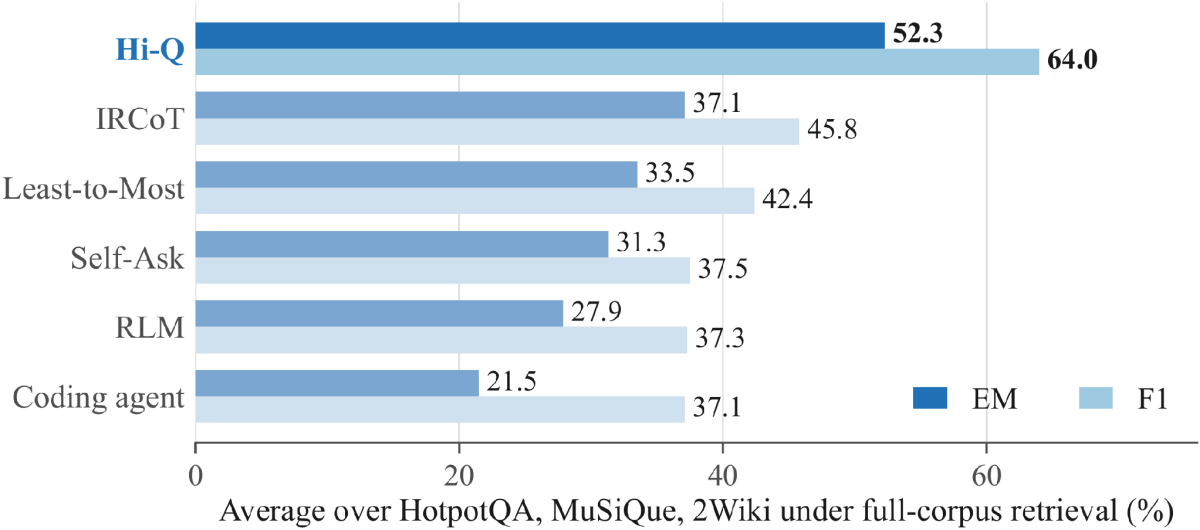
그림 3. 전체 코퍼스 검색 환경에서의 평균 EM / F1 비교.
