


최신연구
-
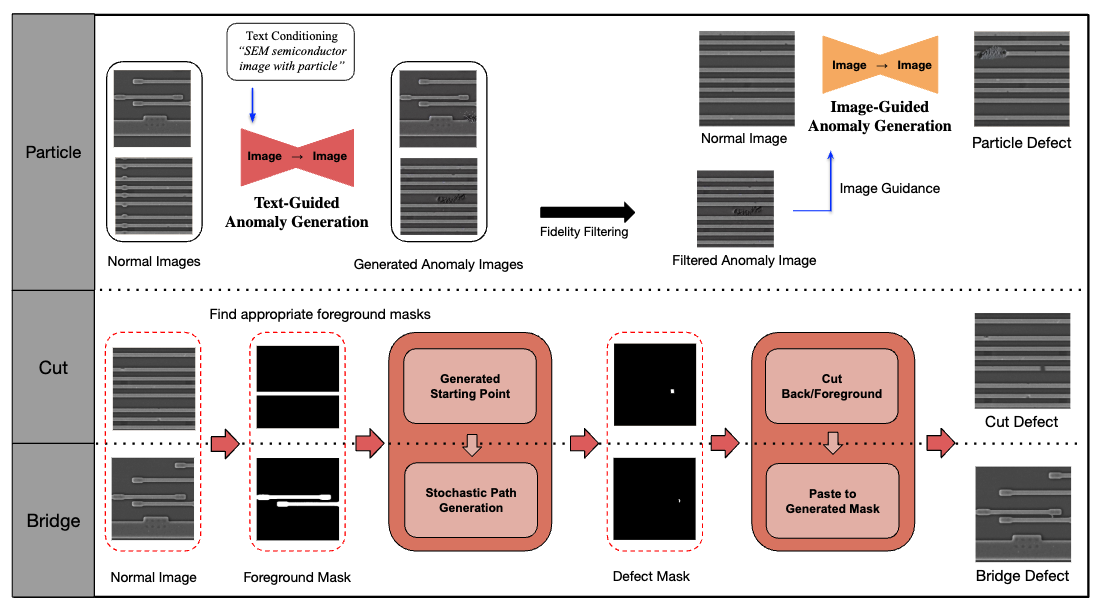
[이남훈 교수] Advancing Semiconductor Inspection: A New Dataset and Approach for Robust Anomaly Detection with Large Vision Language Models
[연구의 필요성] 반도체 제조에서는 주사전자현미경(SEM) 이미지를 활용해 미세 결함을 검출하고, 결함의 종류·위치·형태를 분석하는 과정이 중요하다. 최근 Large Vision-Language Model(LVLM)은 단순한 결함 탐지를 넘어 이러한 정보를 자연어로 설명할 수 있어 반도체 검사 자동화에 활용될 가능성이 높다. 그러나 SEM 이미지는 일반 자연영상과 시각적 특성이 크게 다르고, 실제 반도체 결함 데이터는 보안 및 비용 문제로 확보와 공개가 어려워 LVLM 학습에 필요한 이미지와 언어 데이터를 충분히 구축하기 어렵다. 또한 실제 제조 환경에서는 제품, 공정 단계 및 검사 조건에 따라 SEM 이미지의 분포가 지속적으로 변화하기 때문에, 특정 환경에서 학습한 모델의 성능이 새로운 환경에서 크게 저하될 수 있다. 이에 따라 제한된 실제 결함 데이터만으로도 반도체 도메인에 특화된 LVLM을 학습하고, 새로운 공정 환경에서도 추가적인 데이터 라벨링 없이 성능을 유지·회복할 수 있는 방법이 필요하다. [포스텍이 가진 고유의 기술] 본 연구는 반도체 SEM 데이터 부족과 공정 변화에 따른 성능 저하 문제를 함께 해결하기 위해, 합성 결함 데이터 구축과 시각 표현 기반의 모델 적응 방법을 제안한다. 먼저 실제 정상 SEM 이미지에 particle, cut, bridge의 대표적인 반도체 결함을 합성하고, 각 이미지에 결함의 존재 여부, 종류, 위치 및 형태에 대한 instruction 데이터를 생성하여 OASIS 데이터셋을 구축하였다. 특히 결함마다 발생 형태가 다르다는 점을 고려하여 particle에는 생성 모델 기반 방법을, 회로의 연결 구조 자체가 변화하는 cut과 bridge에는 구조 정보를 활용한 결함별 합성 방식을 적용함으로써 실제 SEM 구조를 보존하면서 다양한 결함 데이터를 생성하였다. 또한 새로운 제품이나 공정으로 데이터 분포가 변화할 때 LVLM의 최종 응답 성능은 저하되더라도 visual encoder에는 결함을 구분할 수 있는 정보가 비교적 잘 유지된다는 점을 규명하였다. 이를 바탕으로 라벨이 없는 새로운 환경의 이미지에 대해 visual encoder의 결함 정보를 활용하여 학습 데이터를 스스로 생성하고, 이를 통해 LVLM을 추가적인 사람의 라벨링 없이 새로운 환경에 적응시키는 방법을 제안하였다. [연구의 의미] 본 연구는 실제 반도체 결함 데이터가 부족한 환경에서도 합성 데이터와 LVLM을 활용하여 결함 탐지와 설명이 가능한 모델을 구축할 수 있음을 보였다. OASIS는 10,000장의 실제 정상 SEM 이미지와 6,000장의 합성 결함 이미지 및 이에 대응하는 instruction 데이터를 포함하며, 이를 활용한 학습을 통해 기존 LVLM의 반도체 결함 탐지 성능을 크게 향상시켰다. 실제 MIIC 데이터에서 LLaVA-OV의 F1-score는 18.1에서 75.2로, Anomaly-OV는 4.7에서 60.9로 향상되었으며, 학습에서 사용하지 않은 다른 SEM 데이터에서도 성능 향상이 유지되었다. 또한 제품 및 공정 변화가 큰 환경에서도 visual encoder가 보유한 결함 정보를 활용하면 별도의 추가 라벨링 없이 모델의 성능을 회복할 수 있음을 보였으며, 어려운 sub-domain 환경에서 LLaVA-OV의 F1-score를 64.71에서 85.14로, Anomaly-OV를 90.04에서 96.57로 향상시켰다. 이는 데이터 확보가 제한적인 반도체 제조 환경에서 합성 데이터를 통한 학습과 무라벨 적응을 결합하여 LVLM의 실제 적용 가능성을 높였다는 점에서 학술적·산업적 의의가 있다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 컴퓨터 비전 분야의 주요 국제학술대회인 British Machine Vision Conference (BMVC 2026)에 채택되었다. 향후에는 현재 제안한 방법을 다양한 반도체 제품 및 공정 환경으로 확장하고, 새로운 환경에서의 결함 탐지뿐만 아니라 결함의 위치와 형태를 보다 정확하게 설명할 수 있도록 LVLM의 생성 성능을 개선하는 것을 목표로 한다. 또한 visual encoder가 새로운 환경에서도 유지하는 강건한 시각 정보를 LVLM의 최종 응답으로 보다 효과적으로 전달할 수 있는 방법을 연구하여 실제 반도체 검사 환경에서의 적용 가능성을 더욱 높일 계획이다. [성과와 관련된 실적] Jaehyeon Jeong*, Hyeondo Jang*, Donghyun Oh, Seungeun Kim and Namhoon Lee, Advancing Semiconductor Inspection: A New Dataset and Approach for Robust Anomaly Detection with Large Vision Language Models, BMVC 2026 [성과와 관련된 이미지]
이남훈 교수 2026.08.31 66 -
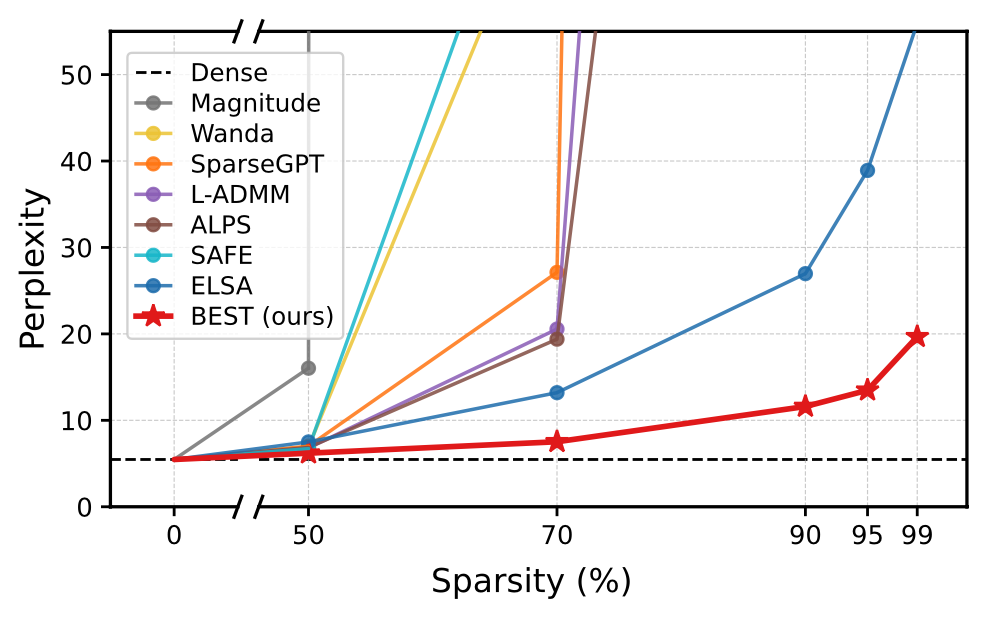
[이남훈 교수] Hidden in Plain Sight: The Overlooked Significance of Canonical Elements for Extreme LLM Sparsity
[연구의 필요성] 거대 언어 모델의 규모가 지속적으로 증가함에 따라 모델 구동에 필요한 연산량과 메모리 비용 또한 크게 증가하고 있으며, 이를 절감하기 위한 모델 압축 기술의 중요성이 커지고 있다. 특히 불필요한 파라미터를 제거하는 가지치기(pruning)는 모델의 크기와 연산량을 동시에 줄일 수 있는 핵심적인 압축 기법이다. 기존 거대 언어 모델 가지치기 연구는 계산 비용을 최소화하기 위해 한 번에 파라미터를 제거하는 one-shot 방식에 주로 집중해 왔으며, 높은 성능을 유지할 수 있는 희박도 역시 약 70% 수준에 머물러 있었다. 최근 연구를 통해 90% 수준의 희박도에서도 모델의 성능을 유지할 수 있는 가능성이 확인되었으나, 어떤 파라미터를 제거할 것인지, 희박도를 어떤 방식으로 증가시킬 것인지, 그리고 가지치기 과정에서 모델을 어떻게 학습할 것인지와 같은 가지치기의 핵심 설계 요소들은 거대 언어 모델 규모에서 충분히 연구되지 않았다. [포스텍이 가진 고유의 기술] 본 연구에서는 거대 언어 모델의 가지치기 과정에서 기존에 충분히 다루어지지 않았던 파라미터 선택, 희박도 증가 방식, 학습 방식의 세 가지 핵심 요소를 체계적으로 설계함으로써, 약 99%의 매우 높은 희박도에서도 기존 방법보다 우수한 성능을 달성할 수 있음을 보인다. 구체적으로, 목적함수의 곡률 정보를 활용한 2차 중요도 지표를 효율적으로 계산하여 제거할 파라미터를 선정하고, 전체 모델의 파라미터 중요도를 바탕으로 희박도를 전역적으로 배분한다. 또한 목표 희박도를 한 번에 적용하는 대신 스케줄링을 통해 점진적으로 증가시키며, 이에 맞춰 학습률(learning rate)을 조정하여 가지치기 과정에서 발생하는 성능 저하를 효과적으로 회복하도록 설계하였다. [연구의 의미] 본 연구는 가지치기의 기본 설계 요소를 적절히 구성하면 거대 언어 모델에서도 95–99%의 높은 희박도까지 성능을 유지할 수 있음을 보였다. LLaMA-2와 Qwen 계열의 다양한 모델에서 기존 방법보다 일관되게 우수한 성능을 달성했으며, 특히 LLaMA-2-7B의 경우 95% 희박도에서 WikiText-2 perplexity 13.48, 99% 희박도에서 19.67을 기록하였다. 이는 동일한 재학습 예산을 사용하는 SparseGPT 기반 방법의 99% 희박도 perplexity 35.53보다 약 1.8배 낮은 수준이다. 또한 95% 희박도의 LLaMA-2-7B 모델에 희소 연산 커널을 적용했을 때 dense 모델 대비 3.23배 높은 decoding throughput과 6.21배의 메모리 절감 효과를 확인하였다. 이러한 결과는 기존에 충분히 다뤄지지 않았던 가지치기 설계 요소가 극한 희박도에서의 성능 확보에 중요함을 보여주며, 거대 언어 모델의 압축과 효율적인 추론 가능성을 한층 확장했다는 점에서 의의가 있다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 2026 한국인공지능학회(CKAIA 2026)에서 한화에어로스페이스 최우수 논문상을 수상하였으며, 이후 EMNLP 2026에도 채택되어 연구의 우수성을 국제적으로 인정받았다. 향후에는 현재의 극한 희박도 성능을 바탕으로 더 큰 규모의 거대 언어 모델로 적용 범위를 확장하고, 높은 희박도에서 저하되는 추론 및 생성 성능을 개선하는 것을 목표로 한다. 또한 실제 하드웨어에서의 효율적인 연산으로 이어질 수 있도록 희소 모델의 구조와 추론 방식에 대한 연구를 확장할 계획이다. [성과와 관련된 실적] 2026 한국인공지능학회 하계학술대회 최우수논문상 수상 Hyeondo Jang, Kwanhee Lee, Dongyeop Lee and Namhoon Lee, Hidden in Plain Sight: The Overlooked Significance of Canonical Elements for Extreme LLM Sparsity, EMNLP 2026 [성과와 관련된 이미지]
이남훈 교수 2026.08.31 58 -
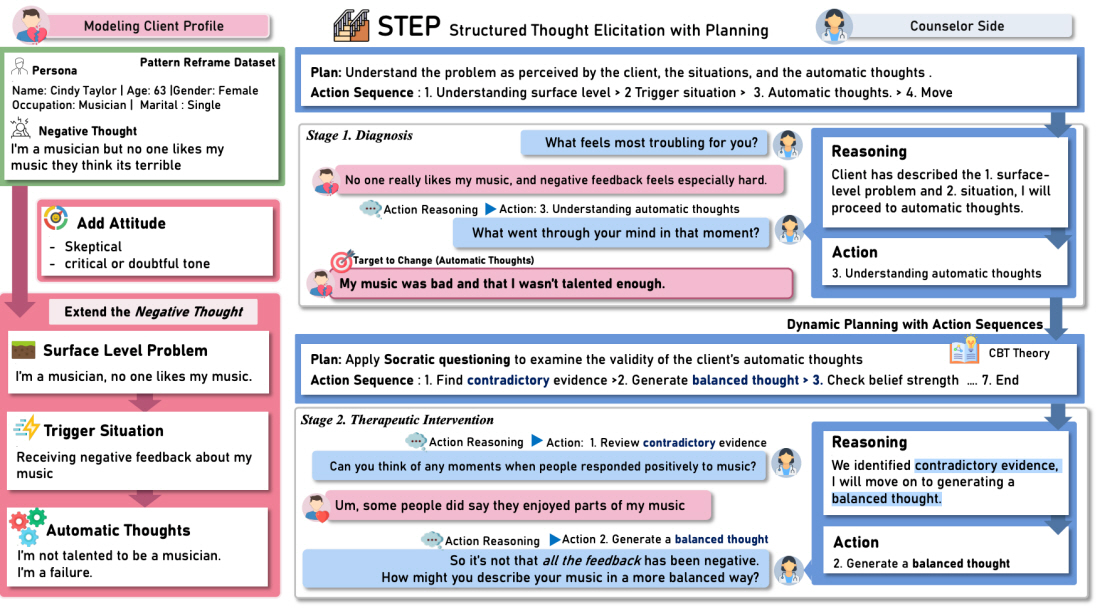
[이근배, 김형훈 교수] PSY-STEP: Structuring Therapeutic Targets and Action Sequences for Proactive Counseling Dialogue Systems
[연구의 필요성] 기존 상담 대화 시스템은 사용자의 발화에 공감하거나 수동적으로 반응하는 데 집중해, 인지행동치료(CBT)의 핵심인 자동적 사고를 파악하고 적절한 치료적 개입으로 연결하는 데 한계가 있습니다. 보다 체계적이고 능동적인 상담을 위해서는 치료 목표와 상담 행동의 순서를 명시적으로 구조화하는 기술이 필요합니다. [포스텍이 가진 고유의 기술] 본 연구는 자동적 사고와 단계별 상담 행동을 함께 구조화한 CBT 상담 데이터셋 STEP과, 이를 기반으로 능동적인 상담을 수행하는 대화 모델 STEPPER를 제안합니다. STEPPER는 사용자의 자동적 사고를 구체적으로 이끌어 내고, 상황에 적합한 인지적 개입을 순차적으로 수행합니다. 또한 합성 상담 세션을 활용한 선호학습을 통해 상담 행동의 선택 정확도와 공감적 반응 능력을 함께 향상했습니다. [연구의 의미] 본 연구는 단순한 공감형 대화를 넘어, 상담 목표와 개입 과정을 구조적으로 계획하는 능동형 AI 상담 시스템의 가능성을 제시합니다. CBT 기반 평가에서 기존 모델보다 임상적 근거성, 대화의 일관성, 개인화 수준 및 상담자 역량이 향상됨을 확인했습니다. 다만 본 시스템은 전문적인 정신건강 치료를 대체하기보다 상담 전문가를 보조하는 기술로 활용될 수 있습니다. [연구결과의 진행 상태 및 향후 계획] 현재 데이터셋과 모델 개발 및 성능 평가를 완료했으며, 연구 논문이 EMNLP 2026 Findings에 채택되었습니다. 향후 실제 상담 환경을 고려한 안전성 및 신뢰성 검증, 다양한 사용자와 상담 상황에 대한 일반화 평가, 전문가 피드백을 반영한 모델 고도화를 진행할 계획입니다. [성과와 관련된 실적] - EMNLP 2026 Findings 채택 - 이지현, 민예진, 전예진, 양성준, 김형훈, 이근배 - PSY-STEP: Structuring Therapeutic Targets and Action Sequences for Proactive Counseling Dialogue Systems [성과와 관련된 이미지]
이근배, 김형훈 교수 2026.08.28 78 -

[백승환 교수] Ambient-robust Inverse Rendering using Active RGB-NIR Imaging
[연구의 필요성] 역렌더링은 영상에서 물체의 3차원 형상, 재질과 조명을 복원하는 기술로, 디지털 트윈과 AR·VR 등에 활용된다. 그러나 기존 RGB 기반 방법은 주변 조명과 물체 고유의 색을 구분하기 어려워 촬영 환경에 따라 복원 결과가 달라지는 한계가 있다. [포스텍이 가진 고유의 기술] 포스텍 연구팀은 RGB 카메라, NIR 카메라와 근적외선 플래시를 결합한 로봇 촬영 시스템을 개발하였다. 사람 눈에 보이지 않는 NIR 조명을 이용해 주변 조명의 영향을 제거하고, RGB와 NIR 영상을 함께 분석하여 물체의 형상, 색상, 거칠기, 금속성과 환경 조명을 안정적으로 복원한다. [연구의 의미] 강한 가시광 조명이나 암실 없이도 다양한 실내외 조명에서 일관된 디지털 물체를 생성할 수 있다. 복원 결과는 새로운 시점이나 조명에서 사실적으로 렌더링할 수 있어 디지털 트윈, 로봇 인식, 콘텐츠 제작과 산업용 3차원 스캐닝에 활용될 수 있다. [연구결과의 진행 상태 및 향후 계획] RGB–NIR 촬영 시스템, 역렌더링 알고리즘과 데이터셋 구축을 완료하였으며, 실제 및 합성 환경에서 기존 방법보다 안정적인 복원 성능을 확인하였다. 향후에는 촬영 속도를 높이고, 복잡한 장면과 반투명·복합 재질까지 복원할 수 있도록 기술을 확장할 계획이다. [성과와 관련된 실적] 연구 결과는 컴퓨터 그래픽스 분야의 최고 권위 학술대회인 ACM SIGGRAPH 2026 Conference Papers에 발표되었다. 논문명: Ambient-robust Inverse Rendering using Active RGB-NIR Imaging 주요 성과: RGB–NIR 역렌더링 알고리즘, 로봇 촬영 시스템, RGB–NIR 데이터셋 개발 [성과와 관련된 이미지]
백승환 교수 2026.08.06 179 -

[이근배 교수] S³: Sequential Self-feeding Slot Prediction for Explainable Cognitive Reframing in Task-Oriented Dialogue
[연구의 필요성] 인지행동치료(CBT)는 효과가 잘 입증된 심리치료 기법이지만, 이를 AI 시스템으로 구현하는 데에는 한계가 존재한다. 소형 언어모델(SLM)은 치료적 추론을 안정적으로 수행하기 어렵고, 반면 대형 언어모델(LLM)은 저자원 환경에 배포하기에는 연산·비용·데이터 프라이버시 측면에서 부담이 크다. 특히 인지 재구조화(cognitive reframing)와 같은 CBT 핵심 기법은 임상적 감독을 위해 모델의 추론 과정이 설명 가능해야 하지만, 기존 대화형 CBT 시스템들은 규칙 기반 방식에 머물러 있거나 내담자의 인지 상태 변화를 구조적으로 추적하지 못한다는 한계를 보였다. 이에 따라 경량 모델로도 CBT의 이론적 구조를 따르는 설명 가능한 대화 상태 추적(dialogue state tracking) 프레임워크의 필요성이 제기된다. [포스텍이 가진 고유의 기술] 본 연구에서는 인지 재구조화를 과업지향형 대화(Task-Oriented Dialogue, TOD) 문제로 재정의하고, 사건(Event)·생각(Thought)·증상(Symptom)·인지왜곡(Cognitive Distortion)·내담자 인지왜곡(Client Cognitive Distortion)의 다섯 가지 신념 상태(belief state)를 명시적으로 추적하는 대화 상태 추적 모듈을 설계하였다. 이를 뒷받침하기 위해 공황장애를 대상으로 한 6,800여 개의 합성 대화 데이터셋 CREPAN(Cognitive REframing for PANic disorder)을 구축하였다. 또한 사건이 아니라 그 사건에 대한 해석이 정서적 반응을 유발한다는 심리학 이론인 Ellis의 ABC 모델에 이론적 근거를 둔 순차적 자기공급 슬롯 예측 기법 S³(Sequential Self-feeding Slot Prediction)를 제안하였다. S³는 Event→Thought→Symptom→Cognitive Distortion→Client Cognitive Distortion→System Response의 인과적 순서에 따라 각 단계의 예측값을 다음 단계의 입력으로 재사용함으로써, SLM도 LLM에 준하는 치료적 추론을 수행할 수 있도록 하는 경량 스캐폴딩 구조이다. [연구의 의미] S³을 적용한 T5(S³-T5)는 JGA(Joint Goal Accuracy) 0.7781을 기록하며 80억 파라미터 규모의 LLaMA-3(0.7423), Qwen-3(0.7291)를 능가하는 성능을 보였으며, 자유형 텍스트 슬롯 평가를 위해 새롭게 제안한 Soft Match 지표에서도 모든 LLM 기준선을 상회하였다. 이는 CBT 스타일 대화 상태 추적에서 성능을 좌우하는 핵심 요인이 모델의 파라미터 규모가 아니라 인지이론에 기반한 구조적 추론 순서임을 실증적으로 보여준다. 아울러 순서를 무작위화하거나 역순으로 바꾼 절제 실험에서 일관되게 성능이 저하됨을 확인하여, S³의 예측 순서가 임의적인 것이 아니라 CBT의 인과적 논리를 반영한 것임을 검증하였다. 이러한 결과는 자원 제약 환경에서도 임상적으로 신뢰할 수 있는 설명 가능한 디지털 정신건강 시스템 구축이 가능함을 시사한다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 ACM Transactions on Computing for Healthcare에 출판을 앞두고 있으며, S³ 코드와 CREPAN 데이터는 GitHub를 통해 공개되어 있다. 향후에는 다른 질환군으로의 일반화 가능성을 검증하고 임상 전문가 평가를 통해 확장할 계획이다. [성과와 관련된 실적] ACM Transactions on Computing for Healthcare, Just Accepted (2026) / 김수빈, 김훈래, 이근배 / S³: Sequential Self-feeding Slot Prediction for Explainable Cognitive Reframing in Task-Oriented Dialogue [성과와 관련된 이미지]
이근배 교수 2026.08.06 174 -

[김형훈 교수] SPLIT: Training-Free AI-Generated and Partially Edited Video Detection via Spatial Patch‑Level Incoherence and Temporal Roughness
[연구의 필요성] 최근 텍스트·이미지 기반 영상 생성 기술이 빠르게 발전하면서, 완전히 생성된 영상뿐 아니라 실제 영상의 일부만 자연스럽게 편집한 조작 영상도 쉽게 만들어지고 있다. 이러한 영상은 허위 정보, 사칭, 콘텐츠 위·변조 등에 악용될 수 있으나, 실제 서비스 환경에서는 정상 사용자의 진짜 영상을 잘못 차단하는 오탐률을 극도로 낮게 유지해야 한다. 특히 0.1% 수준의 매우 낮은 False Positive Rate(FPR)에서 조작 영상을 얼마나 잘 찾아내는지가 중요하지만, 기존의 평균적 성능 지표나 학습 기반 검출기는 새로운 생성 모델이나 부분 편집 영상에 취약하다는 한계가 있었다. [포스텍이 가진 고유의 기술] 본 연구는 별도의 학습 없이 AI 생성 및 부분 편집 영상을 검출하는 SPLIT(Spatial Patch-Level Incoherence and Temporal Roughness) 기술을 제안한다. SPLIT은 사전학습된 시각 인코더에서 영상의 패치 단위 특징을 추출하고, 각 패치가 시간에 따라 얼마나 불규칙하게 변화하는지를 측정하는 Two-step Temporal Roughness(TTR)와, 인접한 패치들의 움직임 변화가 공간적으로 얼마나 불일치하는지를 측정하는 Local Spatial Motion Incoherence(LSMI)를 계산한다. 두 신호를 감마 보정 기반으로 결합함으로써, 전체 영상 수준에서는 잘 드러나지 않는 국소적 조작 흔적까지 효과적으로 포착하며, 실제 영상만을 이용해 임계값을 보정하는 서비스 지향 평가 방식도 함께 제시하였다. [연구의 의미] SPLIT은 부분 편집 영상 벤치마크인 FakeParts, 기존 생성 모델 기반 GenVideo, 최신 2024–2025년 생성 모델을 포함한 ViF-Bench에서 모두 우수한 성능을 보였으며, 특히 실제 서비스에 중요한 FPR 0.1% 조건에서 기존 학습 기반 및 훈련 없는 검출 방법을 크게 상회하였다. 또한 압축, 블러, 좌우·상하 반전 등 일반적인 후처리에도 강건하고, 기존 인코더의 특징 추출 이후 매우 작은 추가 계산만으로 동작한다. 본 연구는 빠르게 변화하는 생성형 영상 환경에서 재학습 없이 일반화 가능한 검출 방향을 제시하고, 실제 서비스 배치에 적합한 초저오탐 AI 영상 검출 기준을 마련했다는 점에서 의미가 크다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 컴퓨터 비전 최우수 학회인 ECCV 2026에 수락되어 발표될 예정이다. [성과와 관련된 실적] SPLIT: Training-Free AI-Generated and Partially Edited Video Detection via Spatial Patch‑Level Incoherence and Temporal Roughness Jongyeop Hyun and Hyounghun Kim. ECCV 2026. [성과와 관련된 이미지]
김형훈 교수 2026.08.06 195 -

[류일우 교수] SPHARM-Mamba: Rotation-Invariant Multiscale Modeling for Brain Age Prediction
[연구의 필요성] 뇌 나이(Brain Age)는 정상적인 뇌 발달과 노화 과정을 평가하고 신경퇴행성 질환을 조기에 발견하기 위한 중요한 바이오마커이다. 기존 표면 분석 모델은 패치 기반 처리 방식으로 인해 계산 비용이 크고 회전에 민감하여 해부학적 정렬이나 데이터 증강이 필요하다. 본 연구는 이러한 한계를 극복하기 위해 구면조화 기반의 회전 불변 정보를 활용하고, Mamba를 이용해 전역 구조와 국소 구조를 함께 학습하는 새로운 프레임워크를 제안하였다. [포스텍이 가진 고유의 기술] 본 연구에서는 Spherical Harmonics 기반 Mamba 프레임워크(SPHARM-Mamba)를 제안함으로써 대뇌 피질 표면 기반 Brain Age Prediction 문제를 해결하고자 하였다. 이 프레임워크는 다음과 같은 특징을 가진다. (1) 대뇌 피질 표면 신호를 구면조화(Spherical Harmonics) 영역으로 변환한 후, SHConv를 통해 회전에 강인한 스펙트럼 특징을 학습한다. 이후 harmonic degree별 정보를 회전 불변 특성으로 변환하여 전역 구조에서 국소 구조로 이어지는 시퀀스를 구성한다. (2) 자연스럽게 정렬된 harmonic degree 시퀀스를 Mamba 기반 상태공간모델(State Space Model)로 학습하여, 전역적인 형태 정보와 국소적인 형태 정보를 동시에 반영하는 다중 스케일 표현을 효과적으로 학습한다. (3) 제안한 프레임워크는 패치 분할이나 해부학적 정렬 없이도 회전에 강인한 표면 분석을 수행하며, 기존 표면 기반 딥러닝 모델 대비 약 30% 향상된 Brain Age Prediction 성능을 달성하였다. 또한 적은 모델 파라미터로도 높은 예측 정확도를 확보하여 다양한 의료영상 표면 분석 문제에 적용 가능한 범용 프레임워크를 제시하였다. [연구의 의미] 본 연구는 구면조화 기반 표면 표현과 Mamba를 결합하여 회전에 강인하면서도 전역 및 국소 구조를 동시에 반영하는 새로운 표면 분석 방법을 제시하였다. 이를 통해 기존 패치 기반 모델의 한계를 극복하고, 다양한 표면 기반 의료영상 분석 문제에 활용 가능한 범용 프레임워크를 제안하였다. [연구결과의 진행 상태 및 향후 계획] 본 연구에서는 공개 뇌 MRI 데이터셋을 이용한 Brain Age Prediction에서 기존 방법보다 우수한 성능을 확인하였다. 향후에는 제안한 프레임워크를 다양한 의료영상 분석 과제에 확장하여 여러 작업에서도 우수한 성능을 보이는 범용성을 검증하고, 모델을 더욱 고도화하여 국제 저널에 후속 연구를 제출할 계획이다. [성과와 관련된 실적] Junho Choi, Mingyu Joo, Jiwon Son, Won Hwa Kim, and Ilwoo Lyu, “SPHARM-Mamba: Rotation-Invariant Multiscale Modeling for Brain Age Prediction”, Medical Image Computing and Computer Assisted Intervention (MICCAI), 2026 [성과와 관련된 이미지]
류일우 교수 2026.08.06 161 -

[박상돈/김동우/김형훈 교수] ChronoBias: A Benchmark for Evaluating Time-conditional Group Bias in the Time-sensitive Knowledge of Large Language Models
[연구의 필요성] 거대 언어 모델의 효과적인 성능에도 불구하고 환각 현상은 여전히 존재하며, 동일한 주제임에도 불구하고 특정 그룹 (e.g., 성별, 인종, 인기도)에 따라 성능 및 품질의 편향이 발생할 경우 기존 편향을 심화시킬 수 있는 문제를 겪어 왔다. [포스텍이 가진 고유의 기술] 기존 그룹 편향 측정의 경우 시간에 따라 변화하는 지식에 대해서도 시간에 대하여 주변화된 그룹 편향 측정 지표를 활용하여 확인할 수 없었던 문제점을 시간에 대하여 조건화된 그룹 편향 측정 방안 및 이를 활용한 데이터 분석 결과를 제공함으로써 확인했습니다. [연구의 의미] 주어진 결과는 신뢰할 수 있는 인공지능 모델을 개발하는 맥락에서, 시변적인 지식에 대해서 거대 언어 모델이 보이는 그룹 편향을 보다 적확하게 모니터링할 수 있는 가능성을 제시하였다는 점에서 의의가 있습니다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 현재 EMNLP Findings 2025에 채택되었고, 향후 단순한 질의응답 과업을 넘어선 agentic task 상에서 발생할 수 있는 그룹 편향 측정 및 분석 연구로 확장할 계획이다. [성과와 관련된 실적] 김경민, 최영빈, 김형훈, 김동우, 박상돈 (POSTECH 컴퓨터공학과/인공지능대학원) ChronoBias: A Benchmark for Evaluating Time-conditional Group Bias in the Time-sensitive Knowledge of Large Language Models (EMNLP Findings 2025 논문 채택) [요약] 본 연구는 시변적 지식에 대해 시간에 대해 조건화된 그룹 편향을 측정할 수 있는 지표를 새롭게 제안하고, 관련 분석을 수행할 수 있는 ChronoBias라는 benchmark 데이터셋을 제안했습니다. [성과와 관련된 이미지]
박상돈, 김동우, 김형훈 교수 2026.07.21 279 -

[류일우 교수] Shape-Adaptive Guidance Signal for Interactive Cortical Sulcal Labeling
[연구의 필요성] 대뇌 피질의 고랑(sulcus)은 개인 간 뇌의 구조적 차이와 기능적 특성을 분석하기 위한 중요한 해부학적 지표로 제안되고 있다. 특히 Lateral Prefrontal Cortex (LPFC)를 비롯한 여러 피질 영역에는 크기가 작고 형태와 위치의 개인차가 큰 고랑들이 존재하고, 이들과 고위 인지기능과의 관계를 분석하는 연구가 진행되고 있다. 그러나 이러한 고랑들은 자동 라벨링 과정에서 오류가 발생하기 쉬워, 분석에 활용하기에 앞서 전문가의 추가적인 검증과 교정이 수반되어야 한다. 본 연구에서는 소수의 전문가 클릭만으로 고랑 라벨링 결과를 효율적으로 교정할 수 있는 상호작용 프레임워크를 제안한다. [포스텍이 가진 고유의 기술] 본 연구에서는 Spherical CNN 기반 Interactive Segmentation 프레임워크를 제안함으로써 대뇌 피질 고랑 라벨링 문제를 해결하고자 하였다. 이 프레임워크는 다음과 같은 특징을 가진다. (1) 대뇌 피질 표면을 구면에 매핑한 후, Spherical CNN을 통해 대뇌 표면의 기하학적 특징과 현재 라벨링 결과, 그리고 사용자 클릭으로부터 생성된 Spatial Guidance Signal을 입력으로 하여 고랑 라벨을 교정한다. (2) 긍정 및 부정 클릭을 반복적으로 반영하는 학습 방식을 통해, 사용자의 추가적인 상호작용에 따라 정확도를 단계적으로 개선한다. (3) 백색질(White Matter) 표면의 평균 곡률을 기반으로 한 신호의 전파 속도 함수를 설계하였다. 또한 클릭 위치에서 시작된 신호의 전파를 Eikonal Equation으로 모델링함으로써, 대뇌 표면의 형상을 반영하는 Shape-Adaptive Guidance Signal을 생성하였다. 이를 통해 신호가 클릭이 위치한 고랑을 따라 전파되도록 유도하고, 인접한 이랑(Gyrus)로의 불필요한 확산을 억제하였다. [연구의 의미] 본 연구에서 제안한 Shape-Adaptive Guidance Signal는 대뇌 형상을 고려하지 않는 단순한 신호에 비해 LPFC 영역상의 크기가 작고 개인차가 큰 고랑에서 높은 라벨링 정확도를 보였으며, 반복적인 클릭에 따라서도 결과를 안정적으로 개선하였다. 이는 대규모 고랑 라벨링 작업에 있어 전문가의 검증 및 교정 부담을 줄일 수 있는 가능성을 보여준다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 의료영상 분야 최우수 국제학술대회인 Medical Image Computing and Computer Assisted Intervention (MICCAI) 2026에서 발표될 예정이다. 후속 연구에서는 대뇌의 해부학적 특징과 현재 라벨링 상태에 따라 Guidance Signal의 전파 범위를 자동으로 조절하는 방법을 개발할 예정이다. [성과와 관련된 실적] Jiwon Son, Ethan H. Willbrand, Benjamin J. Parker, Kevin S. Weiner, Ilwoo Lyu, “Shape-Adaptive Guidance Signal for Interactive Cortical Sulcal Labeling”, Medical Image Computing and Computer Assisted Intervention (MICCAI), 2026 [성과와 관련된 이미지]
류일우 교수 2026.07.21 188
