


최신연구
[한욱신 교수] CADENZA: 자연어 의도에 따른 시맨틱 질의 처리 최적화
- 등록일2026.10.15
- 조회수15
-

교수한욱신
[연구의 필요성]
최근 데이터베이스에서도 “특정 브랜드의 상품 사진을 찾아줘”처럼 자연어로 조건을 지정해 텍스트·이미지·음성 데이터를 분석하는 기술이 주목받고 있다. 이를 가능하게 하는 ‘시맨틱 연산자’는 데이터의 의미를 인공지능 모델로 판단한다. 그러나 많은 데이터에 대규모 모델을 반복 호출하면 처리 시간과 비용이 크게 증가하고, 어떤 모델과 처리 방식을 선택하느냐에 따라 결과의 품질도 달라진다.
핵심은 단순히 더 작거나 저렴한 모델로 바꾸는 것만으로는 충분하지 않다는 점이다. 예를 들어 상품 포장에 특정 문구가 있는지 확인하는 작업은 이미지를 대규모 모델에 직접 입력할 수도 있지만, 이미지에서 글자를 읽은 뒤 해당 문구를 판별하는 여러 단계로 나눌 수도 있다. 같은 목적에도 여러 처리 방법이 존재하므로, 자연어로 주어진 의도에 맞춰 작업의 구조와 각 단계의 실행 방법을 함께 최적화하는 기술이 필요하다.
[포스텍이 가진 고유의 기술]
POSTECH 한욱신 교수·하재현 박사과정 연구진은 미국 일리노이대학교 어바나-샴페인(UIUC)의 Yongjoo Park 교수와 공동으로 시맨틱 연산자 최적화 시스템 ‘CADENZA’를 개발하였다. CADENZA는 하나의 시맨틱 연산자를 통째로 모델에 맡기는 대신, 의도에 맞는 세부 작업들의 연결 구조로 변환하고 사용자가 원하는 결과 품질·처리 시간·비용의 균형에 따라 실행 계획을 선택한다. 핵심 기술은 다음 세 가지이다.
(1) 세부 작업을 데이터베이스 최적화 대상으로 표현: 문자 인식, 이미지 설명 생성, 텍스트 질의응답 등 세부 작업을 기존의 필터·조인·집계 연산과 함께 표현하는 ‘태스크 확장 관계 대수(TxRA)’를 제안하였다. 각 작업이 만든 텍스트·답변·점수를 중간 데이터로 드러내어, 이후 연산에서 활용하고 처리 순서나 판별 기준을 조정할 수 있도록 하였다.
(2) 자연어 의도에 따른 실행 계획 탐색: 언어모델과 연산자 카탈로그를 이용해 초기 계획을 생성하고, 데이터 형식과 작업 간 연결 관계를 검사한다. 이어 구조적 변환과 대안 작업 구성을 통해 후보를 확장한다. 이미지에서 직접 답을 구하는 방법과 문자 인식 후 텍스트를 분석하는 방법처럼 결과 품질이 달라질 수 있는 대안은 동일한 결과를 낸다고 가정하지 않고, 검증 데이터에서 평가하여 선택한다.
(3) 입력별 실행 방식과 파라미터의 공동 최적화: 각 세부 작업에서 입력의 특성에 따라 규칙 기반 처리, 소형 전문 모델, 대규모 범용 모델 등을 선택한다. 쉬운 입력은 저렴한 방식으로 처리하고 어려운 입력에 더 강력한 모델을 활용하도록 라우팅한다. 베이지안 최적화를 이용해 이러한 라우팅 기준, 모델별 설정, 최종 필터의 임계값을 함께 조정하여 전체 실행 계획의 품질·시간·비용을 개선한다.
[연구의 의미]
본 연구는 시맨틱 질의 최적화를 ‘어떤 모델을 사용할 것인가’에서 ‘어떤 세부 작업으로 나누고, 각 작업을 어떻게 실행할 것인가’로 확장하였다. 특히 인공지능 추론의 중간 결과를 데이터베이스 연산과 연결함으로써, 대규모 모델 호출 내부에 가려져 있던 처리 과정을 최적화 대상으로 만들었다는 데 의의가 있다.
텍스트·이미지·음성을 포함하는 SemBench의 5개 시나리오, 55개 질의에서 기존 시맨틱 질의 처리 시스템 및 워크플로 최적화 방식과 비교하였다. LOTUS와 비교 가능한 질의들을 집계한 결과, CADENZA는 평균 품질 점수를 0.10 높이면서 최적화 시간을 포함한 전체 처리 시간을 3.80배, 비용을 4.88배 개선하였다. 품질은 질의별 평가 점수 차이의 산술평균이며, 시간·비용은 기존 시스템 대비 비율의 기하평균이다. 집계에서 비교 시스템이 지원하지 않거나 실패한 질의는 제외하였고, 일부 시간 초과 사례의 시간·비용에는 소규모 실행에 근거한 추정치가 포함된다.
이러한 접근은 상품 정보 분석, 문서 검토, 이미지·음성 기반 데이터 탐색처럼 서로 다른 형태의 데이터를 함께 다루는 업무에 활용될 수 있다. 사용자는 자연어로 분석 목적을 지정하고, 서비스의 품질 요구와 운영 비용에 맞춰 실행 방식을 선택할 수 있다.
[연구결과의 진행 상태 및 향후 계획]
본 연구 논문은 데이터베이스 분야의 대표 국제학술대회인 ACM SIGMOD 2027에 채택되었으며, 학술지 Proceedings of the ACM on Management of Data(PACMMOD) 4권 4호, Article 265로 게재되었다. 이와 별도로 시스템의 활용 과정을 다룬 ‘CADENZA in Action’은 VLDB 2026 데모 논문으로 채택되었다. 데모는 웹 인터페이스에서 자연어 의도가 여러 후보 계획으로 분해되는 과정과 품질·시간·비용 선호에 따라 선택되는 계획이 달라지는 모습을 보여준다.
향후에는 후보 실행 계획을 평가하는 데 드는 최적화 비용을 줄이고, 단일 시맨틱 연산자를 넘어 여러 연산자 사이의 의존성을 고려하는 최적화로 연구를 확장할 계획이다. 논문과 공개 코드를 통해 관련 연구 및 시스템 개발에 활용할 수 있도록 하였다.
[성과와 관련된 실적]
Ha, J., Park, Y., and Han, W., “CADENZA: Compiling Natural-Language Intent into Task-Specific Operator DAGs for Semantic Query Processing,” Proceedings of the ACM on Management of Data, Vol. 4, No. 4, Article 265, 2026 (ACM SIGMOD 2027). DOI: 10.1145/3837103
Ha, J., Park, Y., and Han, W., “CADENZA in Action: Breaking the Monolith with Intent-Dependent Plan Spaces for Semantic Queries,” Proceedings of the VLDB Endowment, Vol. 19, No. 12, pp. 4634–4637, 2026 (VLDB 2026 Demo). DOI: 10.14778/3827998.3828084
[성과와 관련된 프로젝트 및 논문 링크]
공개 코드: https://github.com/postechdblab/CADENZA
본 논문: https://arxiv.org/abs/2606.29151
데모 논문: https://arxiv.org/abs/2607.01468
[성과와 관련된 이미지]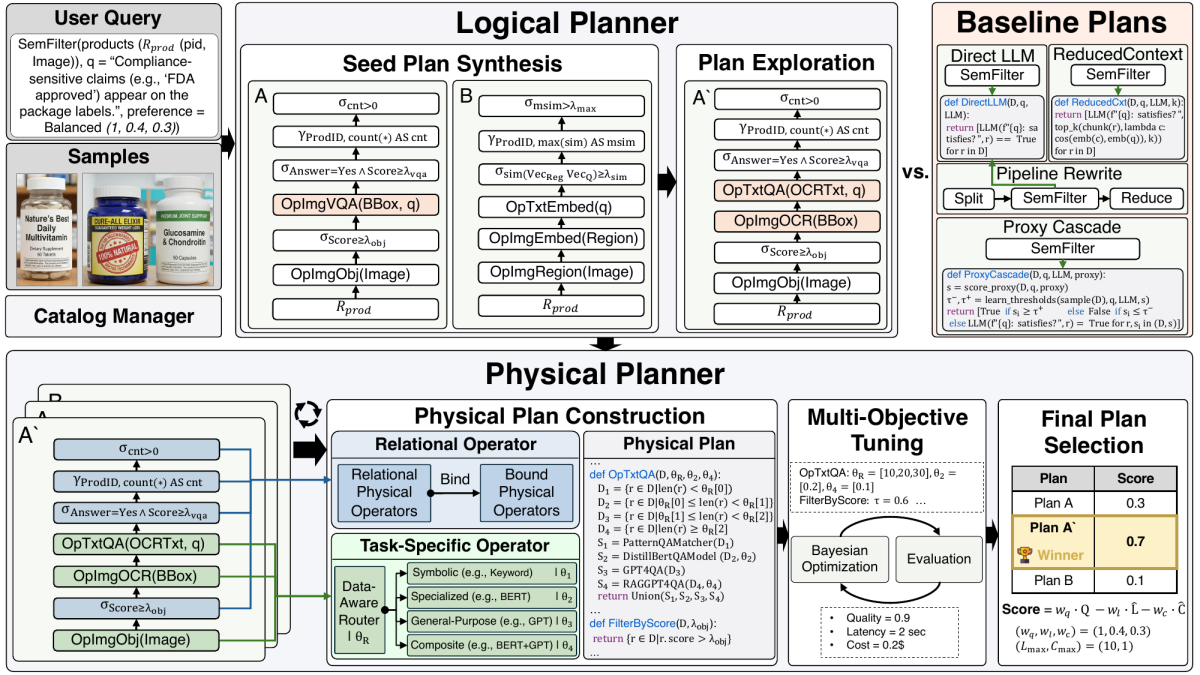
- 그림 1. CADENZA의 전체 구조. 자연어 의도를 여러 후보 실행 계획으로 분해한 뒤, 각 작업의 실행 방식과 파라미터를 함께 조정하여 품질·시간·비용 선호에 맞는 계획을 선택한다. (본 논문 시스템 개요 그림)
