


최신연구
[박상현 교수] Rethinking RAG: Mitigating Text-Driven Hallucinations via Feature-Level Retrieval Integration in Medical LVLMs
- 등록일2026.10.12
- 조회수20
-

교수박상현
[연구의 필요성]
의료 대형 비전-언어 모델(Med-LVLM)은 의료 영상을 바탕으로 판독 보고서를 생성하고 진단 질문에 답할 수 있는 모델로 주목받고 있다. 그러나 실제 영상과 모순되는 내용을 생성하는 환각(hallucination) 현상이 빈번하며, 이를 완화하기 위해 도입된 기존 검색 증강 생성(RAG) 기법은 검색된 보고서를 텍스트로 덧붙이는 방식이어서 모델이 영상 대신 다른 환자의 보고서를 그대로 따라 쓰는 한계가 있다. 또한 널리 쓰이는 CLIP 기반 검색은 “녹내장 소견 없음”과 “녹내장”처럼 상반된 문장을 구분하지 못해 임상적으로 모순되는 사례를 가져오기도 한다. 따라서 검색된 정보를 활용하면서도 실제 영상 근거에 기반해 판단하도록 하는 새로운 RAG 기술이 필요하다.
[포스텍이 가진 고유의 기술]
본 연구는 검색된 정보를 텍스트 입력이 아닌 시각 특징 단계에서 통합하는 새로운 RAG 프레임워크를 제안하였다. 검색된 영상-보고서 쌍을 비전 인코더 내부의 게이트형 교차 주의(gated cross-attention) 모듈로 융합하여, 모델이 참고 보고서를 그대로 복사하지 않고 강화된 시각 특징을 통해서만 검색 정보를 활용하도록 하였다. 또한 주의가 소수의 참고 사례에만 쏠리는 것을 막는 그라운딩 손실(grounding loss)과, 부정 표현을 구분해 임상적으로 모순되는 사례를 걸러내는 부정 인식 검색(negation-aware retrieval) 기법을 함께 제안하였다.
[연구의 의미]
본 연구는 검색 정보를 텍스트로 덧붙이는 기존 의료 RAG의 구조적 한계를 해결하고, 검색 정보를 시각 표현 강화에 활용하는 새로운 방향을 제시했다는 점에서 의미가 있다. 흉부 X-ray와 안과 영상 등 3개 벤치마크의 진단 질의응답 및 판독 보고서 생성에서 기존 최신 기법보다 우수한 성능을 달성하였으며, 모델이 영상 정보에 기울이는 주의 비중도 크게 회복시켰다. 이는 다른 환자의 기록이 아닌 현재 환자의 영상에 근거해 판단하는, 신뢰할 수 있는 의료 AI 개발에 기여할 수 있다.
[연구결과의 진행 상태 및 향후 계획]
- 본 연구는 MICCAI 2026에 조기채택(Provisional Accept, 약 9%)되었고, 포스터로 발표되었다. 향후에는 임상적 유효성 평가, 개방형 질의응답, 최신 의료 비전-언어 모델 등으로 검증 범위를 확장하여, 실제 임상 판독 보조 환경에 적용 가능한 신뢰성 높은 의료 AI 기술로 발전시킬 계획이다.
[성과와 관련된 실적]
본 연구 논문 “Rethinking RAG: Mitigating Text-Driven Hallucinations via Feature-Level Retrieval Integration in Medical LVLMs”은 MICCAI 2026에 게재되었다.
[성과와 관련된 이미지]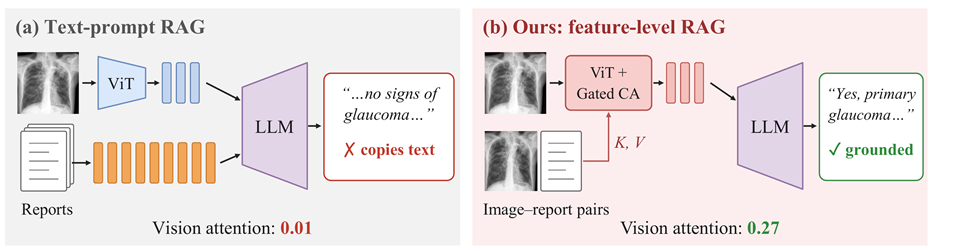
- 그림 1. 기존 텍스트 기반 RAG(a)와 제안하는 특징 수준 RAG(b) 비교
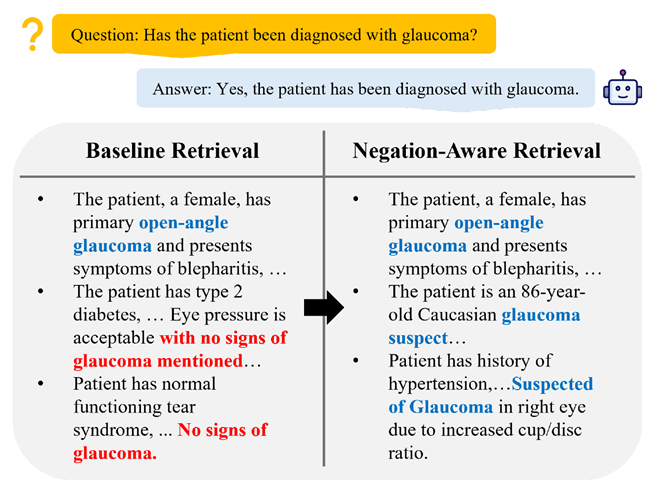
- 그림 2. 기존 검색과 부정 인식 검색의 검색 결과 비교 (정성평가)
