


최신연구
-

[한욱신 교수] Failure is Feedback: History-Aware Backtracking for Agentic Traversal in Multimodal Graphs
[연구의 필요성] 웹페이지나 PDF에는 문단, 표, 이미지가 서로 연결된 형태로 정보가 존재한다. 이러한 멀티모달 문서에서 사용자의 질문에 답하기 위해 관련 구성요소(component)를 정확히 찾아내는 검색 기술은 검색증강생성(RAG)을 뒷받침하는 핵심 기반 기술이다. 그러나 기존의 그래프 기반 검색 방식들은 두 가지 본질적인 한계를 가진다. 첫째, 그래프 위에서 다음 노드를 결정할 때 단순한 임베딩 벡터 유사도에만 의존하는 획일적인 점수 함수를 사용하기 때문에, 검색 단계(hop)마다 달라지는 의미적 맥락을 충분히 반영하지 못한다. 둘째, 검색 계획이 사전에 고정되어 있어 잘못된 경로를 따라갔거나 막다른 길에 도달했을 때 동적으로 오류를 수정하기 어렵다. 이로 인해 한 번의 잘못된 선택이 이후 단계까지 그대로 전파되어 최종 검색 품질을 크게 떨어뜨리며, 어느 단계에서 강력한 추론을 투입해야 하는지 판단할 메커니즘이 없어 단계마다 비용을 낭비하거나 반대로 추론이 부족한 상황이 빈번하게 발생한다. [포스텍이 가진 고유의 기술] 본 연구진은 그래프 검색 과정을 ‘순차적 의사결정 과정’으로 새롭게 정식화한 검색 프레임워크 Failure is Feedback(FIF)을 제안하였다. FIF의 핵심은 다음 두 가지이다. (1) 이력 기반 백트래킹(history-aware backtracking): 기존 백트래킹이 단순히 상태를 이전으로 되돌리는 데 그치는 반면, FIF는 실패한 탐색 경로의 맥락 자체를 적극적으로 활용한다. 지금까지의 성공·실패 이력 중 가장 유망한 이전 시점으로 검색 시작점을 재고정(re-anchoring)하고, 실패의 단서를 반영해 하위 질의를 다시 작성하며, 동일한 실패 패턴을 반복하지 않도록 검색 전략을 한 단계 상향시킨다. 즉 실패의 흔적 자체를 다음 검색을 위한 ‘피드백 신호’로 전환한다. (2) 비용 효율적인 에이전트형 검색 흐름(economically-rational agentic workflow): FIF는 저비용 벡터 매칭부터 고비용 LLM 추론까지, 정확도와 효율성의 균형을 조절할 수 있는 검색 전략 포트폴리오를 사용한다. 검색 전 과정을 통제하는 오케스트레이터(Orchestrator)는 이전 시도가 모호하거나 실패한 경우에 한해서만 더 비싼 추론으로 격상시키는 비용 인식 탐색을 수행하여, 검색 정확도와 추론 비용 사이의 균형을 동적으로 조절한다. [연구의 의미] FIF는 멀티모달 다중 단계 질의응답 벤치마크 세 종 모두에서 최고 수준의 검색 성능을 달성하였고, 검색 결과를 바탕으로 한 최종 질의응답 단계에서도 기존의 강력한 경쟁 기법들보다 우수한 성능을 보였다. 특히 FIF는 더 정교한 에이전트 제어를 사용하면서도 강력한 에이전트형 기준선과 비교해 경쟁력 있는 응답 시간을 유지했으며, 일부 대규모 데이터셋에서는 더 빠른 처리 시간을 보였다.이는 실패 이력에 기반한 재고정과 비용 인식 전략 격상이 불필요한 추론을 효과적으로 제거함을 의미한다. 또한 FIF는 여러 상용 및 공개 가중치 LLM 백본에서 성능 향상 효과를 검증했으며, 충분한 추론 능력을 갖춘 다양한 백본에서 강력한 검색 성능을 유지했다. 이는 FIF의 성능 향상이 특정 상용 모델에만 의존하기보다, 본 연구진이 제안한 오케스트레이션 논리와 실패 이력 활용 방식에서 비롯됨을 보여준다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 기계학습 분야 세계 최고 권위의 학술 대회인 ICML(International Conference on Machine Learning) 2026에 게재가 확정되어 발표될 예정이며, 코드와 실험 자료는 프로젝트 홈페이지를 통해 공개되어 재현성을 갖추었다. [성과와 관련된 실적] Yun, J., Lee, D., and Han, W., "Failure is Feedback: History-Aware Backtracking for Agentic Traversal in Multimodal Graphs," In Proc., the 43rd International Conference on Machine Learning, ICML, Seoul, South Korea, July 2026. [성과와 관련된 프로젝트 홈페이지] https://failureisfeedback.github.io/ [성과와 관련된 이미지] 그림 1. 기존 그래프 기반 검색 방법이 멀티모달 다중 단계 질의에서 실패하는 두 가지 대표 사례를 보여주는 예시그림 2. 멀티모달 문서 코퍼스를 표현한 계층화된 구성요소 그래프의 예시 그림 3. Failure is Feedback(FIF)의 전체 구조와 검색 과정에서 누적되는 구조화된 메모리의 예시
한욱신 교수 2026.05.27 786 -
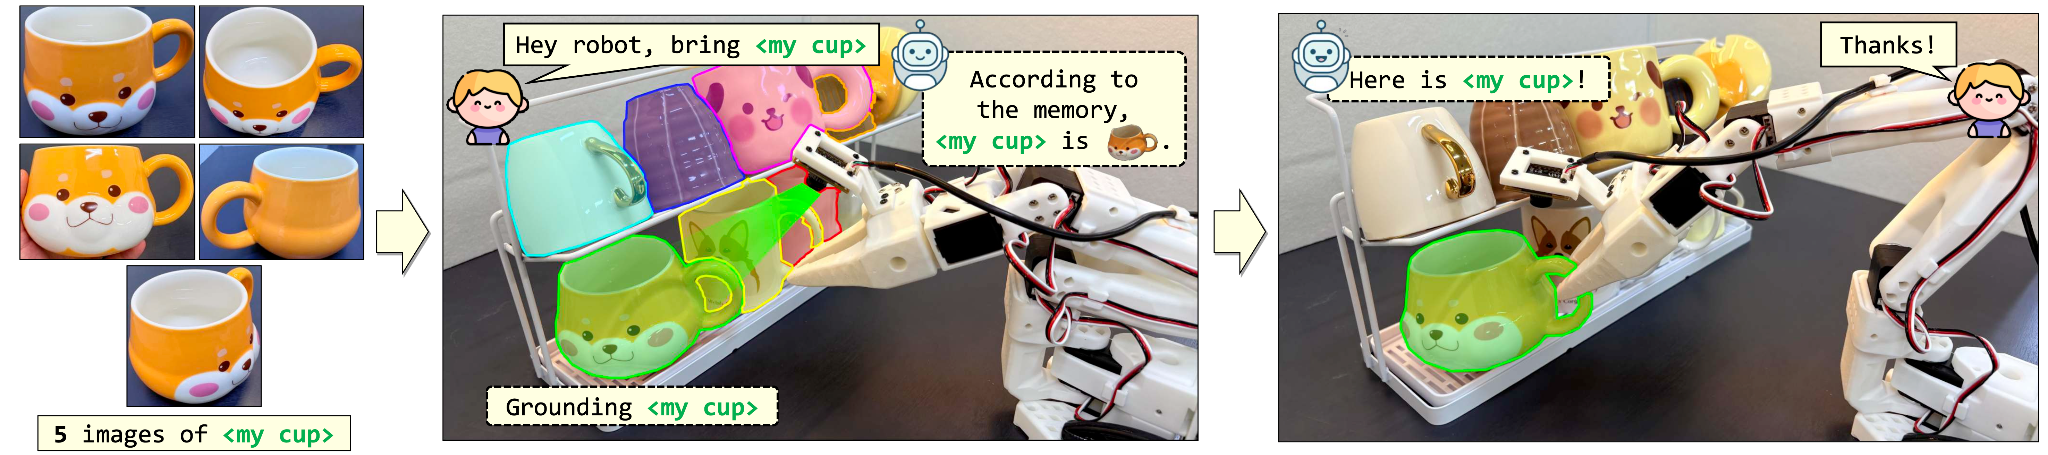
[한욱신 교수] Bring My Cup! Personalizing Vision-Language-Action Models with Visual Attentive Prompting
[연구의 필요성] 가정·사무실·병원 등 실제 생활 환경에서 로봇이 유용하게 동작하려면 “컵을 가져와”와 같은 일반적인 범주 수준의 명령뿐 아니라, “내 컵을 가져와”처럼 특정 사용자의 물건을 정확히 구분하고 조작할 수 있어야 한다. 그러나 기존 시각-언어-행동(Vision-Language-Action, VLA) 모델은 대규모 로봇 데이터로 학습되어 일반적인 물체 범주는 잘 이해하지만, 학습 중 본 적 없는 개인 물체나 사용자별 지칭 표현에는 취약하다. 예를 들어 여러 개의 컵이 함께 놓여 있을 때, 기존 모델은 “내 컵”을 사용자의 특정 컵이 아니라 단순히 “컵”이라는 범주로 해석하여 시각적으로 유사한 다른 컵을 집거나 옮기는 실패를 보인다. 이 문제는 언어 설명을 더 자세히 제공하는 것만으로 해결되기 어렵다. 개인 물체를 구별하는 핵심 단서는 표면 무늬, 손잡이 모양, 작은 장식, 마모 흔적처럼 말로 완전하게 표현하기 어려운 미세한 시각적 특징에 있기 때문이다. 또한 실제 환경에서는 사용자마다 새로운 물체가 계속 추가되므로, 물체별로 모델을 다시 학습하는 방식은 데이터 수집과 계산 비용 측면에서 비현실적이다. 따라서 소수의 참조 사진만으로 사용자의 특정 물체를 찾아내고, 기존 모델의 파라미터를 수정하지 않으면서도 해당 물체를 안정적으로 조작하게 만드는 개인화 조작 기술이 필요하다. [포스텍이 가진 고유의 기술] 본 연구진은 개인 물체 조작 문제를 해결하기 위해 Visual Attentive Prompting(VAP, 시각 주의 유도 방식)을 제안하였다. VAP는 기존 시각-언어-행동 모델의 파라미터를 수정하거나 물체별로 재학습하지 않고, 입력 단계에서 시각 단서와 언어 명령을 함께 변환하여 고정된 모델이 사용자의 특정 물체를 조작하도록 유도하는 training-free 개인화 기술이다. (1) 참조 사진 기반 시각 기억과 개인 물체 식별: VAP는 사용자가 제공한 소수의 물체 사진을 시각 기억으로 저장한다. 로봇이 현재 장면을 관측하면, 먼저 명령문에서 “내 컵”과 같은 표현으로부터 일반 물체 범주를 추출하고, 개방형 어휘 객체 검출기를 이용해 해당 범주의 후보 물체들을 찾는다. 이후 시각 특징 벡터를 사용하여 각 후보 물체와 참조 사진들을 비교하고, 여러 참조 사진이 가장 일관되게 지지하는 후보를 개인 물체로 선택한다. 선택된 후보는 픽셀 단위 마스크로 정교하게 분할되며, 이후 추적 모듈을 통해 로봇 팔이나 집게가 물체를 일시적으로 가리더라도 같은 물체를 계속 따라갈 수 있도록 시간에 따라 갱신된다. (2) 시각-언어 결합 지시를 통한 모델 제어: VAP는 선택된 개인 물체 영역 위에 반투명 색상 표시를 입혀 모델이 어느 물체에 주의해야 하는지 명시적으로 알려준다. 동시에 원래 명령문도 “내 컵을 집어라”에서 “빨간색 컵을 집어라”처럼 시각 표시와 일치하는 표현으로 다시 작성한다.즉, 시각 표시는 “어디를 볼지”를 알려주고, 바뀐 명령문은 “무엇을 조작할지”를 언어적으로 고정한다. 이 두 요소가 함께 작동함으로써, 기존 모델이 보유한 일반 물체 조작 능력을 사용자의 특정 물체에 적용할 수 있게 된다. [연구의 의미] 본 연구는 시각-언어-행동 모델의 개인화 문제를 “사용자별 물체를 유사한 물체들 사이에서 구분하고 조작하는 문제”로 정식화하고, 이를 평가하기 위해 두 가지 시뮬레이션 벤치마크와 실제 로봇 평가 환경을 구축하였다.이는 기존 평가가 주로 물체 범주 수준의 일반화에 머물렀던 한계를 넘어, 실제 인간-로봇 상호작용에 필요한 개별 물체 수준의 개인화를 본격적으로 다룬다는 점에서 의미가 있다. 실험 결과, VAP는 기존 VLA 모델, 언어 설명 기반 프롬프트 방식, 학습 토큰 기반 개인화 방식보다 높은 성공률과 올바른 물체 조작 성능을 보였다. 특히 시뮬레이션과 실제 로봇 환경 모두에서 개인 물체 식별 및 조작 성능을 크게 향상시키면서도, 제어 단계당 약 0.02초의 작은 추적 비용만 추가하여 실시간 제어 가능성을 유지하였다. 또한 본 연구는 정적 이미지에서 물체를 알아보는 능력이 곧 실제 조작 성공으로 이어지지는 않음을 보였다. 학습 토큰 기반 방식은 정적 이미지 인식 단계에서는 개인 물체를 어느 정도 구분할 수 있었지만, 폐루프 조작 과정에서는 주의가 시간에 따라 흔들리거나 유사한 다른 물체로 옮겨가는 한계를 보였다. 반면 VAP는 매 프레임 외부 시각 표시를 통해 물체의 정체성을 다시 고정함으로써, 기존 모델의 일반 조작 능력을 사용자별 물체 조작으로 확장하였다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 기계학습 분야 최고 권위 학술대회 중 하나인 ICML 2026에 게재가 확정되어 발표될 예정이다. 또한 공식 구현 저장소를 통해 코드, 실행 스크립트, 평가 환경 설정 방법이 공개되어 있어 연구 결과를 재현할 수 있다. [성과와 관련된 실적] Lee, S., Mo, S., and Han, W., “Bring My Cup! Personalizing Vision-Language-Action Models with Visual Attentive Prompting,” In Proc., the 43rd International Conference on Machine Learning, ICML, Seoul, South Korea, July 2026. [성과와 관련된 프로젝트 홈페이지] https://vap-project.github.io/ [성과와 관련된 이미지]그림 1. 참조 사진으로 사용자의 개인 물체를 찾아 시각적으로 표시하고 조작을 유도하는 VAP의 핵심 아이디어.그림 2. 유사 물체들 사이에서 참조 사진만으로 개인 물체를 찾아 조작해야 하는 VAP 평가 벤치마크. 그림 3. 시각 기억, 물체 식별, 마스크 추적, 시각 표시와 명령문 재작성을 결합한 VAP의 전체 처리 흐름.
한욱신 교수 2026.05.27 788 -

[이남훈 교수] Quantifying Aleatoric Uncertainty of In-Context Learning for Robust Measure of LLM Prediction Confidence
[연구의 필요성] 대규모 언어모델(LLM)은 별도의 학습 없이도 프롬프트 안의 몇 가지 예시만으로 새로운 과제를 수행하는 In-Context Learning (ICL) 능력을 보인다. 그러나 ICL 기반 예측은 프롬프트 형식, 예시의 순서, 데이터 특성에 민감하게 달라지며, 모델이 주어진 컨텍스트를 실제로 얼마나 잘 이해했는지에 따라서도 신뢰성이 크게 좌우된다. 따라서 LLM의 예측 실패가 데이터 자체의 모호성에서 비롯된 것인지, 혹은 모델의 지식 및 표현 능력 부족에서 비롯된 것인지 구분하기 어렵다. 기존 불확실성 측정 방법들은 주로 일반적인 텍스트 생성 환경을 대상으로 설계되어 ICL 특유의 컨텍스트 의존성과 프롬프트 민감성을 충분히 반영하지 못했으며, ICL 환경에서 불확실성 분해가 제대로 이루어졌는지를 평가할 체계적인 기준도 부재했다. 이에 따라 ICL 기반 LLM 예측의 신뢰성을 높이기 위한 새로운 불확실성 분해 방법과 평가 체계가 필요하다. [포스텍이 가진 고유의 기술] 본 연구는 ICL 상황에서 LLM의 예측 불확실성을 데이터 자체의 모호성에서 오는 불확실성(aleatoric uncertainty)과 모델의 지식·이해 부족에서 오는 불확실성(epistemic uncertainty)으로 분해하기 위해 self-function vector라는 새로운 방법을 제안하였다. Self-function vector는 ICL 수행에 중요한 attention head의 내부 활성값을 활용해, 주어진 프롬프트가 모델 내부에서 어떤 잠재 개념으로 표현되는지를 포착하는 벡터이다. 이를 통해 출력 결과나 디코딩 변화에만 의존하던 기존 방법과 달리, 모델 내부 표현을 직접 활용하여 데이터 자체의 모호성에서 발생하는 불확실성을 보다 안정적으로 추정할 수 있다. 또한 연구진은 synthetic task와 WordNet 기반 multiple-choice question 데이터셋을 활용하여, aleatoric uncertainty와 epistemic uncertainty를 각각 통제하고 평가할 수 있는 ICL 특화 평가 프로토콜을 새롭게 제시하였다. [연구의 의미] 본 연구는 LLM의 ICL 예측 신뢰성을 분석하기 위해 불확실성 정량화와 메커니스틱 해석가능성(mechanistic interpretability)을 연결했다는 점에서 의의가 크다. 특히 모델 내부의 task representation을 활용함으로써, 단순히 예측이 불확실하다는 사실을 넘어 그 불확실성이 데이터의 모호성 때문인지, 모델의 한계 때문인지를 구분할 수 있는 기반을 마련하였다. 실험 결과 제안 방법은 다양한 LLM과 데이터셋에서 기존 방법보다 안정적으로 불확실성을 분해했으며, 환각 탐지(hallucination detection)와 같은 신뢰성 중심 응용에서도 실용 가능성을 보였다. 이는 향후 안전하고 신뢰 가능한 생성형 AI 시스템 개발에 중요한 기반이 될 것으로 기대된다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 자연어처리 분야 최고 권위의 국제 학술대회인 Annual Meeting of the Association for Computational Linguistics (ACL 2026)에 구두발표(oral presentation) 논문으로 채택되었다 (상위 약 3.98%; 483/12,148). 향후 연구에서는 self-function vector가 Bayesian posterior 구조를 어느 정도 반영하는지에 대한 이론적 분석을 강화하고, 모델별 하이퍼파라미터 조정 없이 다양한 LLM 아키텍처에 적용 가능한 일반화된 방법으로 확장하는 것을 목표로 한다. [성과와 관련된 실적] Jinseok Chung, Minkyoung Song*, Hyunji Jung*, Namhoon Lee. “Quantifying Aleatoric Uncertainty of In-Context Learning for Robust Measure of LLM Prediction Confidence”, Annual Meeting of the Association for Computational Linguistics (ACL), 2026. [성과와 관련된 이미지]
이남훈 교수 2026.05.27 701 -
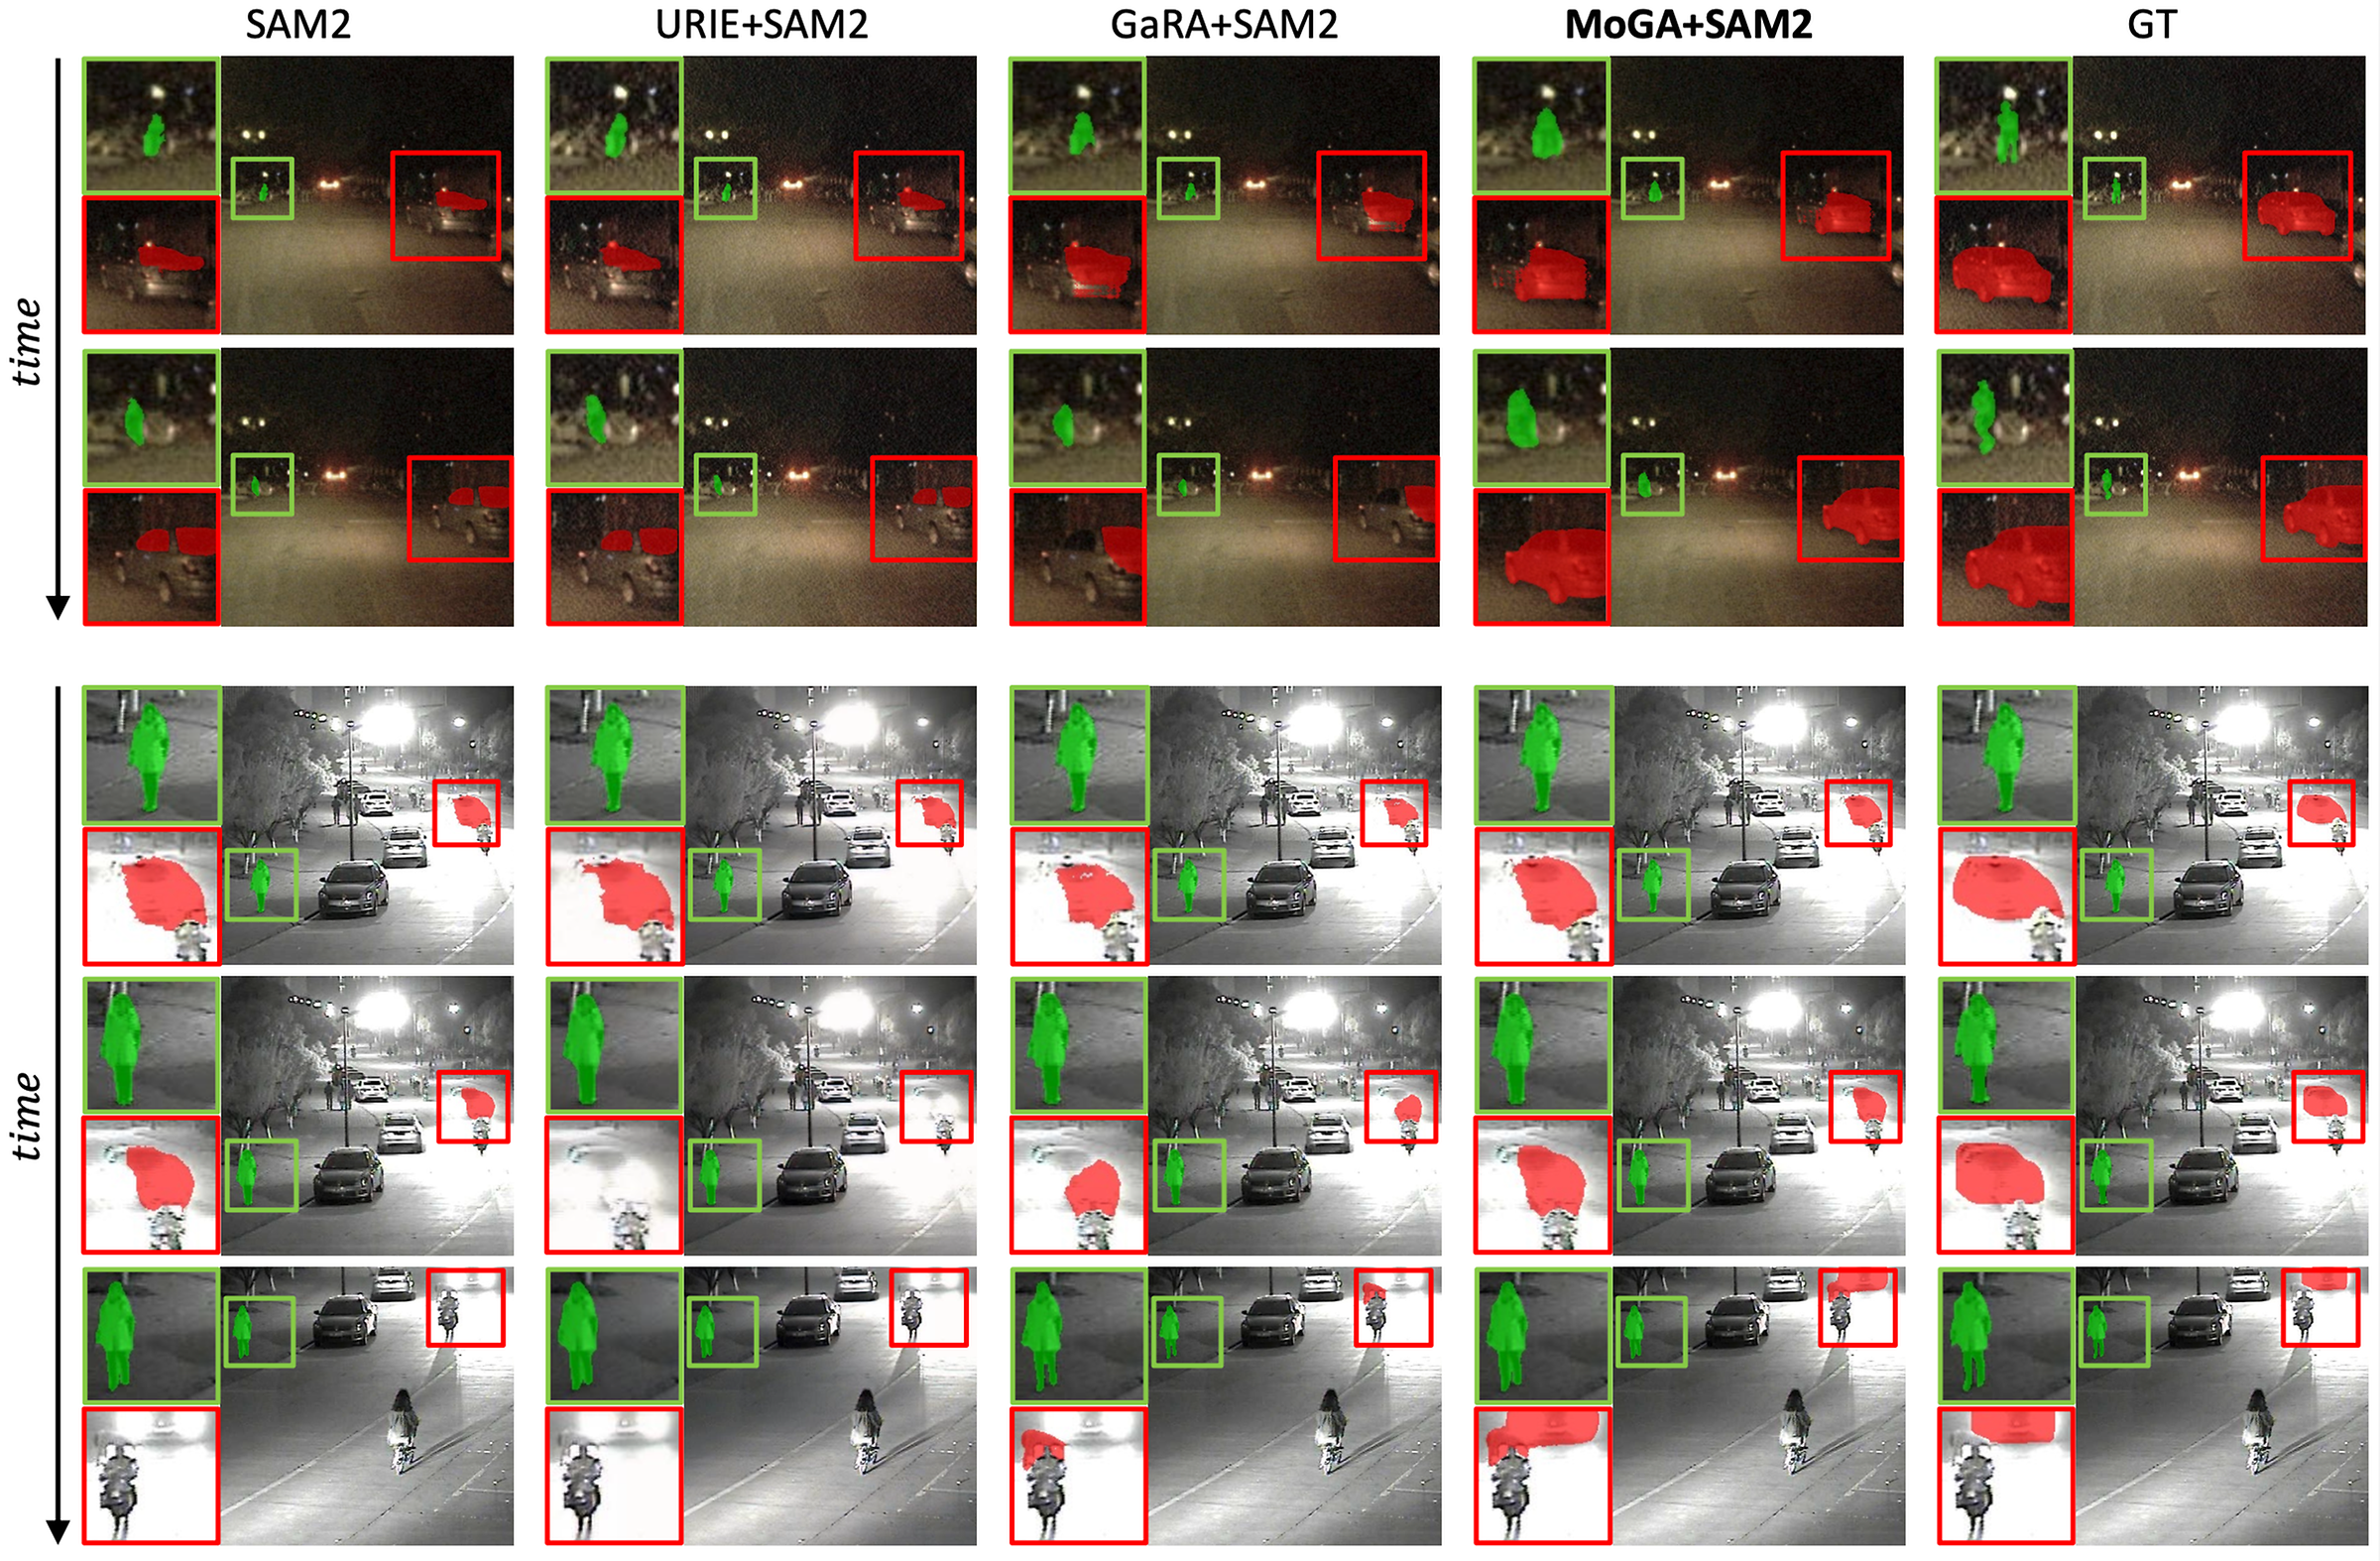
[곽수하 교수] Robust Promptable Video Object Segmentation
[연구의 필요성] 프롬프트 기반 영상 객체 분할(Promptable Video Object Segmentation, PVOS)은 사용자가 첫 프레임에서 점·박스·마스크 등으로 지정한 객체를 이후 모든 프레임에 걸쳐 자동으로 추적·분할하는 기술로, 자율주행, 로봇 비전, 영상 편집, 재난·국방 모니터링 등 다양한 응용 분야에서 핵심적인 역할을 한다. 최근 메타(Meta)가 공개한 SAM2(Segment Anything Model 2)는 PVOS 분야에서 인상적인 제로샷 성능을 보이며 주목받고 있으나, 본 연구에서 분석한 결과 SAM2를 비롯한 최신 모델들은 안개, 비, 눈, 야간, 모션 블러와 같이 실제 환경에서 흔히 발생하는 영상 손상(corruption) 상황에서 성능이 크게 저하되는 것으로 나타났다. 이는 안전이 필수인 자율주행·로봇 분야로의 실용화에 큰 걸림돌이 되어 왔다. 기존의 강건한(robust) 영상 분할 연구들은 대부분 정지 이미지에 초점이 맞춰져 있어, 시간에 따라 손상 강도가 변하고 같은 장면 안에서도 객체마다 손상 정도가 다른(예: 안개 속에서 멀리 있는 차량은 거의 보이지 않지만 가까운 보행자는 선명한) 비디오 특유의 복잡한 손상 패턴을 다루지 못한다는 한계가 있었다. 이에 따라 영상의 시간적 흐름과 객체별 손상 차이를 동시에 고려할 수 있는 새로운 방법론과, 이를 체계적으로 평가할 수 있는 벤치마크의 필요성이 대두되었다. [포스텍이 가진 고유의 기술] 본 연구에서는 악조건 영상에서의 프롬프트 기반 객체 분할(RobustPVOS)이라는 새로운 연구 문제를 정식으로 정의하고, 이를 위한 종합 벤치마크와 새로운 강건화 방법론을 함께 제안하였다. 먼저 벤치마크 측면에서, 실세계에서 촬영된 안개·눈·비·야간 영상 351개 클립(약 16,840프레임)에 2,543개의 객체 분할 마스크를 직접 정밀 주석하여 세계 최초의 RobustPVOS 평가 데이터셋을 구축하였으며, 학습용으로는 8종의 손상(노이즈·블러·안개·비·눈 등)을 시간에 따라 자연스럽게 변하도록 합성한 약 47,000여 클립(170만 프레임, 390만 객체 마스크) 규모의 대규모 데이터셋을 함께 공개하였다. 방법론 측면에서는 'MoGA(Memory-object-conditioned Gated-rank Adaptation, 기억-객체 조건부 게이트형 저차원 적응)'를 제안하였다. MoGA의 핵심 아이디어는 영상 분할 모델이 본래 가지고 있는 '객체 메모리(memory bank)'를 강건화의 신호로 재해석한 것이다. 영상 속에서 추적되는 각 객체에 대해 이전 프레임들의 정보를 누적해 저장하는 객체 포인터를 활용하여, 모델 내부의 미세한 보정 부품(rank-1 component)을 객체별로 다르게 선택적으로 활성화하도록 게이트(gate) 메커니즘을 학습시킨다. 이를 통해 같은 장면 안에 있는 객체라도 손상 정도에 따라 서로 다른 강건화 경로를 적용하면서도, 메모리에 누적된 정보를 통해 영상 전체에 걸쳐 일관된 분할 결과를 유지할 수 있다. [연구의 의미] 본 연구는 영상 객체 분할 모델의 강건성을 다루는 새로운 연구 영역을 개척했다는 점에서 중요한 의의를 갖는다. 특히 기존 강건화 연구들이 정지 이미지에만 초점이 맞춰져 있어 시간에 따라 변하는 손상과 객체별 손상 차이를 동시에 다루지 못했던 한계를 근본적으로 해결하였으며, 모델이 본래 가지고 있던 객체 메모리 자체를 강건화의 조건 신호로 재해석함으로써 영상 기반 인식 모델의 새로운 강건화 방향을 제시하였다. 또한 객체별로 차별화된 적응 경로를 적용하면서도 메모리를 통해 시간적 일관성을 유지하는 설계는 다중 객체가 등장하는 복잡한 실세계 영상에서 특히 효과적임을 입증하였다. 실험 결과, MoGA는 실세계 악조건 벤치마크(MVSeg-adv, ACDC-Video)와 합성 손상 벤치마크(YouTube-VOS-C) 모두에서 기존 SAM2 대비 일관된 성능 향상을 달성하였으며, 영상 복원 기반 방법(URIE, AirNet)이나 프레임 단위 강건화 방법(GaRA)보다 우수한 성능을 보였다. 특히 SAM2 전체 8,090만 개 파라미터 중 단 1.1M(약 1.4%)만 학습하고도 SAM2 전체 재학습(full fine-tuning) 대비 GPU 메모리 12% 절감과 동등 이상의 정확도를 달성하여, 학술적 가치뿐 아니라 산업 현장 적용 가능성도 입증하였다. 본 연구가 공개하는 벤치마크와 데이터셋은 향후 자율주행, 로봇 비전, 재난 현장 영상 분석 등으로 확장될 수 있는 중요한 기술적 토대를 제공한다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 컴퓨터비전 분야 최우수 국제학술대회 CVPR 2026에 게재 승인되었다. 향후에는 자율주행·로봇 등 실제 응용 도메인을 위한 강건성 확보, 이벤트 카메라·LiDAR 등 다중 센서 환경으로의 강건화 기술 확장, 그리고 Google 및 ETH Zürich와의 국제 공동연구를 지속 발전시킬 계획이다. [성과와 관련된 실적] Sohyun Lee, Yeho Gwon, Lukas Hoyer, Konrad Schindler, Christos Sakaridis, Suha Kwak, "Robust Promptable Video Object Segmentation", IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2026. [성과와 관련된 이미지]
곽수하 교수 2026.05.27 680 -

[곽수하 교수] Exploring State-Space Models for Data-Specific Neural Representations
[연구의 필요성] 생성형 AI, 영상 스트리밍, 메타버스 등 초대용량 시각 데이터 활용이 증가하면서, 데이터를 더 효율적으로 압축하고 복원할 수 있는 AI 기반 표현 기술의 중요성이 커지고 있다. 기존 신경망 기반 압축 기술은 데이터의 연속적인 구조를 충분히 반영하지 못하는 한계가 있었다. [포스텍이 가진 고유의 기술] 연구팀은 최근 주목받는 상태공간모델(SSM)을 시각 데이터 압축 문제에 처음으로 접목하고, 이를 다차원 데이터에 적용 가능한 구조인 S3K(Structured State-Space Kernel)로 확장했다. 특히 라플라시안 피라미드 기반 LPNet-S3K 구조를 통해 이미지·동영상·3차원 데이터 압축 성능을 동시에 향상시켰다. [연구의 의미] 이번 연구는 상태공간모델이 단순한 시퀀스 처리 모델을 넘어 데이터 압축과 연속 신호 표현에도 효과적으로 활용될 수 있음을 처음으로 체계적으로 제시했다는 데 의미가 있다. 또한 기존 CNN·Transformer 중심의 압축 구조와 차별화된 새로운 AI 압축 패러다임을 제안했다. [연구결과의 진행 상태 및 향후 계획] 현재 이미지·동영상·3차원 데이터셋에서 기존 최신 기법 대비 우수한 복원 성능을 검증했으며, 국제학회 ICLR 2026에 채택됐다. 향후에는 연산 효율 최적화와 전용 디코더 개발을 통해 실제 영상 스트리밍 및 생성형 AI 시스템에 적용 가능한 방향으로 연구를 확장할 계획이다. [성과와 관련된 실적] - ICLR 2026 논문 채택 - Kodak, CLIC2020, UVG, DAVIS, Objaverse 등 다양한 벤치마크에서 성능 검증 - 기존 NeRV 계열 모델 대비 높은 영상 복원 성능 및 압축 효율 달성 [요약] 본 연구는 생성형 AI 시대에서 중요성이 커지는 ‘효율적 데이터 표현’ 문제를 다루고 있으며, 향후 AI 영상 압축, 실시간 스트리밍, 메타버스 및 멀티모달 AI 시스템 등 다양한 산업 분야로의 확장 가능성이 높다. [성과와 관련된 이미지]
곽수하 교수 2026.05.27 718 -

[이근배 교수] Difficulty-Controllable Cloze Question Distractor Generation
[연구의 필요성] 객관식 빈칸(cloze) 문제는 영어 독해 및 언어 이해 능력을 평가하는 데 널리 사용되지만, 학습자의 수준에 맞는 오답 선택지(distractor)를 자동 생성하는 것은 여전히 어려운 문제이다. 기존 자동 생성 방식은 정답과 지나치게 유사하거나, 반대로 너무 쉬운 선택지를 생성하는 경우가 많아 문제 난이도를 정교하게 제어하기 어렵다. 특히 개인화 학습 환경에서는 학습자의 수준에 따라 다양한 난이도의 문제를 제공하는 것이 중요하지만, 기존 방법은 난이도 조절 기능이 제한적이며, 난이도 정보가 포함된 학습 데이터셋 또한 부족하다. 따라서 별도의 수작업 없이도 난이도를 조절하며 자연스럽고 교육적으로 적절한 distractor를 생성할 수 있는 기술이 요구된다. [포스텍이 가진 고유의 기술] 본 연구에서는 distractor 생성 난이도를 제어하기 위해 정보 제한(Information Restriction) 기반 생성 기법과 멀티태스크 학습 전략을 결합한 새로운 프레임워크를 제안하였다. 특히 정답 생성 모델(answer generator)의 attention score를 활용하여 문맥에서 중요한 단어를 선택적으로 제거하고, 제거 비율에 따라 다양한 난이도의 distractor를 생성하는 방식이 핵심이다. 높은 attention을 가진 정보를 제거할수록 더 다양하고 어려운 distractor가 생성되며, 이를 통해 난이도를 유연하게 제어할 수 있다. 또한 여러 QA 모델의 ensemble과 Box-Cox 정규화를 활용하여 distractor의 난이도를 자동 분류하였고, 생성 모델은 hard/easy 난이도를 동시에 학습하는 multitask learning 구조를 통해 정답과 distractor의 차이를 보다 정교하게 이해하도록 설계되었다. 이 과정은 별도의 대규모 추가 데이터 구축 없이 기존 데이터셋을 자동 증강하여 활용 가능하다는 점에서 차별성을 가진다. [연구의 의미] 본 연구는 difficulty-controllable distractor generation 문제를 해결하기 위해, 난이도를 자동 조절할 수 있는 distractor 생성 프레임워크를 제안하였다. 제안한 방법은 기존 CLOTH 데이터셋의 distractor 수를 평균 3개에서 12개 이상으로 확장하였으며, easy/hard 난이도를 명확히 구분할 수 있는 데이터셋을 구축하였다. 또한 실험 결과, 제안 모델은 GPT-4o보다 distractor 난이도 제어 성능에서 우수한 결과를 보였으며, hard distractor 생성 정확도는 최대 73.25%, easy distractor 생성 정확도는 64.23%를 기록하였다. 인간 평가에서도 생성된 hard distractor가 실제 학습자에게 더 높은 혼동 효과를 유발함을 확인하였다. 이는 생성형 AI를 활용한 적응형 교육 시스템(adaptive learning) 구축 가능성을 보여주는 중요한 성과이며, 향후 개인 맞춤형 문제 생성 및 자동 평가 시스템에 폭넓게 활용될 수 있다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 ACL 2026에 채택되었으며, 현재 distractor 생성 데이터셋과 학습 모델 모두 공개되어 후속 연구에 활용 가능하도록 제공되고 있다. 또한 Gemma 2 9B 기반뿐 아니라 다양한 소형 언어 모델(sLLMs)에서도 성능 검증을 완료하였다. 향후 연구진은 continuous difficulty control과 같은 보다 세밀한 난이도 조절 기법을 추가하고, 영어 교육 외 다양한 도메인 및 문제 유형으로 확장하여 범용적인 교육용 생성 AI 시스템으로 발전시킬 계획이다. 또한 실제 학습자 반응 데이터를 활용한 적응형 난이도 최적화 연구도 진행할 예정이다. [성과와 관련된 실적] ACL 2026 Main Conference Seokhoon Kang, Yejin Jeon, Seonjeong Hwang, Gary Geunbae Lee [성과와 관련된 이미지]
이근배 교수 2026.05.20 701 -

[이근배/김형훈 교수] Mixture-of-Experts with Intermediate CTC Supervision for Accented Speech Recognition
[연구의 필요성] 현재 음성인식 시스템은 주로 소수의 고자원 발화 데이터에 기반해 학습되기 때문에, 다양한 억양을 가진 화자에 대해서는 성능 저하가 크게 발생한다. 특히 강한 비원어민 억양이나 학습에 포함되지 않은 새로운 억양에서는 인식 오류가 더욱 두드러지며, 이는 실제 서비스 환경에서 접근성과 공정성 문제로 이어진다. 논문에서도 기존 accent-agnostic 방식은 일반적 강건성은 높이지만 강한 억양이나 unseen accent에 한계가 있고, accent-specific 방식은 성능은 좋지만 추론 시 accent label이 필요해 확장성이 떨어진다고 지적한다. [포스텍이 가진 고유의 기술] 음성인식 모델 구조와 학습 방법을 함께 설계하여, 전문화(specialization) 와 일반화(generalization)를 동시에 달성하는 MOE-CTC를 제안했다. 이 방법은 FastConformer 기반 ASR에 sequence-level Mixture-of-Experts를 삽입하고, 각 expert에 intermediate CTC supervision을 부여해 단순히 억양을 구분하는 것이 아니라 실제 전사 품질이 좋은 expert로 라우팅되도록 학습한다. 또한 학습 초반에는 accent-aware routing으로 expert specialization을 유도하고, 이후 accent-agnostic training으로 전환하여 추론 시 accent label 없이도 unseen accent까지 대응 가능한 구조를 구현했다. [연구의 의미] 본 연구는 단순히 특정 억양에 맞춘 적응 모델이 아니라, 보지 못한 새로운 억양까지 일반화 가능한 ASR 구조를 제시했다는 점에서 의미가 크다. MCV-ACCENT 벤치마크에서 MOE-CTC는 모든 모델 크기 설정에서 기존 FastConformer 및 관련 MoE 변형보다 더 낮은 WER를 기록했으며, 특히 seen accent에서는 최대 29.3%, unseen accent에서는 최대 27.8%의 상대적 WER 감소를 달성했다. 이는 expert routing을 단순한 분류가 아니라 전사 품질과 직접 연결했을 때, 실제 음성인식 성능 개선으로 이어질 수 있음을 보여준다 [연구결과의 진행 상태 및 향후 계획] 본 연구는 ACL 2026에서 발표될 예정이다. [성과와 관련된 실적] ACL 2026 Main Conference Wonjun Lee, Hyounghun Kim, Gary Guenbae Lee / Mixture-of-Experts with Intermediate CTC Supervision for Accented Speech Recognition [성과와 관련된 이미지]
이근배, 김형훈 교수 2026.05.20 717 -

[이근배/김형훈 교수] A Multi-Agent Framework for Feature-Constrained Difficulty Control in Reading Comprehension Item Generation
[연구의 필요성] 기존 Reading Comprehension(RC) 문항 생성 연구는 문항을 자연스럽게 생성하는 데에는 성과를 보였지만, 목표 난이도에 맞게 세밀하게 제어하는 데에는 한계가 있었다. 특히 단일 프롬프트 기반 방식은 어휘 수준, 지문 길이, 문장 길이, 추론 복잡도와 같은 여러 feature constraint를 동시에 안정적으로 만족시키지 못하였고, 그 결과 생성된 문항이 의도한 난이도 수준에서 벗어나는 문제가 있었다. 따라서 여러 난이도 관련 특성을 함께 만족시키면서도 실제 난이도가 단계적으로 상승하도록 통제할 수 있는 새로운 생성 방식이 필요하였다. [포스텍이 가진 고유의 기술] 본 연구는 MAFIG라는 멀티에이전트 기반 문항 생성 프레임워크를 제안하였다. MAFIG는 Drafter, Evaluator, Planner, Reworder, Editor, Refiner로 구성되며, 지문 생성과 선택지 생성의 두 단계를 거치면서 각 단계마다 생성–평가–수정 과정을 반복 수행하는 구조이다. 이를 통해 문항이 지정된 feature constraint를 엄격하게 만족하도록 유도한다. 또한 단순히 문항을 생성하는 데 그치지 않고, 실제 난이도가 점진적으로 증가하도록 8단계 difficulty-calibrated feature constraint sequence를 설계하였다. 즉, feature를 맞추는 기술과 난이도 상승 구조를 함께 제안한 점이 핵심이다. [연구의 의미] 이 연구의 의미는 RC 문항 생성에서 난이도 제어를 추상적인 level 지시가 아니라, 해석 가능한 feature constraint의 정밀한 만족 문제로 구체화하였다는 점에 있다. 실험 결과 MAFIG는 baseline보다 훨씬 높은 constraint satisfaction과 difficulty alignment를 보였으며, 인간 평가에서도 인접 난이도 단계 간 차이를 가장 잘 드러냈다. 이는 “조건을 정확히 만족시키는 것이 실제 난이도 제어 성능으로 이어진다”는 점을 실증적으로 보여준 결과이다. 따라서 본 연구는 향후 자동 문항 생성 시스템이 단순히 문항을 만들어내는 수준을 넘어, 교육적 의도에 맞게 난이도까지 정교하게 설계할 수 있는 가능성을 제시한 연구라 할 수 있다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 ACL 2026에서 발표될 예정이다. [성과와 관련된 실적] Seonjeong Hwang, Jun Seo, Hyounghun Kim, Gary Geunbae Lee, A Multi-Agent Framework for Feature-Constrained Difficulty Control in Reading Comprehension Item Generation, ACL 2026 [성과와 관련된 이미지]
이근배, 김형훈 교수 2026.05.20 679 -

[이근배/김형훈 교수] Can LLMs Estimate Cognitive Complexity of Reading Comprehension Items?
[연구의 필요성] Reading Comprehension(RC) 문항의 난이도를 사전에 추정하는 것은 적절한 학습 자료 제공과 균형 잡힌 평가 문항 구성을 위해 중요하다. 그러나 기존의 난이도 추정은 대개 시험 시행 후 학습자 응답을 바탕으로 하는 CTT나 IRT에 의존해, 문항 개발 단계에서의 사전 분석에는 한계가 있다. 대안으로 전문가 판단이 활용되지만 비용과 시간이 많이 들고 평가자 간 편차도 존재한다. 또 기존 NLP 기반 접근은 문장 길이, 어휘 친숙도, 의미 유사도 같은 표면적 특성은 다룰 수 있어도, 실제 정답 판단 과정에서 요구되는 인지적 부담은 충분히 포착하지 못한다. 이 논문은 RC 문항의 난이도를 설명하는 핵심 요인으로 Evidence Scope와 Transformation Level에 주목하며, 이러한 인지적 특성들이 기존 도구로 자동 추출하기 어려워 지금까지는 인간 주석에 의존해 왔다고 지적한다. 따라서 확장 가능하고 자동화된 방식으로 RC 문항의 인지적 복잡도를 측정할 수 있는 새로운 방법으로서 LLM의 활용 가능성을 탐색한다. [포스텍이 가진 고유의 기술] 본 연구에서느 LLM이 RC 문항의 인지적 복잡도를 추정할 수 있는지 체계적으로 검증했다. 이를 위해 두 가지 인지 차원인 Evidence Scope와 Transformation Level을 정의하고, 해당 기준으로 776개의 RC 문항을 전문가가 직접 주석한 ReCo 벤치마크를 구축했다. Evidence Scope는 정답 판단에 필요한 근거가 단일 문장인지, 여러 문장인지, 혹은 근거가 불충분한지를 구분하며, Transformation Level은 근거 문장과 진술문 사이의 변형 정도를 word matching, paraphrasing, inference 등으로 세분화했다. GPT-4o를 포함한 8개의 instruction-tuned LLM을 대상으로 zero-shot, one-shot, few-shot, CoT, self-consistency 등 다양한 설정에서 실험하여, LLM이 인간의 인지적 판단을 어느 정도 근사할 수 있음을 보였으며, 특히 일부 오픈소스 모델(Qwen2.5-32B, Mistral-24B)은 특정 설정에서 GPT-4o와 비슷하거나 더 나은 성능을 보였다. 또한 단순한 정답 예측을 넘어, falsifiability judgment, evidence sentence counting, paraphrasing detection, phrase reordering detection 같은 세부 하위 과제를 통해 모델의 강점과 한계를 분석했다. [연구의 의미] 이 연구는 RC 문항 난이도 분석을 단순한 표면 언어 특성이나 정답률 예측이 아니라, 문제 해결 과정에서 요구되는 인지적 복잡도를 중심으로 접근했다는 점에서 의미가 크다. 실험 결과 LLM은 Evidence Scope 분류에서 최고 Macro F1 74.8, 3-level Transformation Level 분류에서 최고 82.0을 기록해, 전문가 수준에는 못 미치지만 인지 복잡도 추정 도구로서 충분한 가능성을 보여주었다. 동시에 연구는 LLM이 정답은 맞히더라도 자신이 실제로 어떤 근거 문장을 사용했는지, 혹은 문장 재배열 같은 미세한 구조 변형을 제대로 인식하지 못하는 경우가 많다는 점도 밝혔다. 이는 향후 문항 난이도 추정, 난이도 제어형 문항 생성, 교육용 NLP 시스템의 해석 가능성 향상에 중요한 기반이 될 수 있다. 또한 일부 오픈소스 모델이 상용 모델에 필적하는 성능을 보였다는 점은, 교육 평가 분야에서 보다 접근 가능한 분석 도구 개발 가능성을 시사한다. [연구결과의 진행 상태 및 향후 계획] 본 연구는 ACL 2026에서 발표될 예정이다. [성과와 관련된 실적] Seonjeong Hwang, Hyounghun Kim, Gary Geunbae Lee, Can LLMs Estimate Cognitive Complexity of Reading Comprehension Items?, ACL 2026 [성과와 관련된 이미지]
이근배, 김형훈 교수 2026.05.20 669
